Speculative Decoding Part 1: 도입 전에 확인해야 할 것들
TL;DR
- 디코드(decode)는 메모리 바운드(memory-bound)입니다. 70B 모델 기준으로 42ms짜리 메모리 읽기 안에 연산(compute)은 0.14ms만 들어 있습니다.
- 투기적 디코딩(speculative decoding)의 속도 향상(speedup)은 파라미터 세 개(수락률(acceptance rate), 드래프터(drafter)의 상대 비용, 추측(speculation) 길이)와 상한 하나로 정리됩니다.
- 이 기법은 연산을 써서 지연 시간(latency)을 줄입니다. 고정된 부하(load)에서는 이득이지만 포화(saturation) 상태에서는 비용입니다.
- 같은 구성이 동작점(operating point)에 따라 2.33배에서 1.16배까지 달라집니다. 동작점 없이 인용된 속도 향상은 표의 칸 하나일 뿐입니다.
디코드에서 GPU는 왜 대부분 기다리고 있을까요?
자기회귀(autoregressive) 생성은 순전파(forward pass) 한 번에 토큰을 하나씩만 만듭니다:
토큰 개를 만들려면 순전파 번이 순서대로 필요하다는 뜻인데, 문제는 연산량이 아니라 이 순차 의존성입니다.
bf16으로 올린 70B 모델의 디코드 단계 하나를 보면, 토큰 하나를 만들기 위해 HBM에서 가중치(weight) 약 140 GB를 읽어야 합니다. 3.35 TB/s인 H100 기준으로 약 42 ms, 초당 24 토큰 정도입니다. 반면 같은 순전파의 연산량은 FLOPs로, 최대 989 TFLOP/s 기준 0.14 ms에 불과합니다. 42 ms짜리 메모리 읽기 안에 연산은 0.14 ms만 들어 있는 셈입니다.
즉 디코드는 2~3 자릿수 차이로 메모리 바운드이고, GPU는 대부분의 시간을 기다리면서 보냅니다.
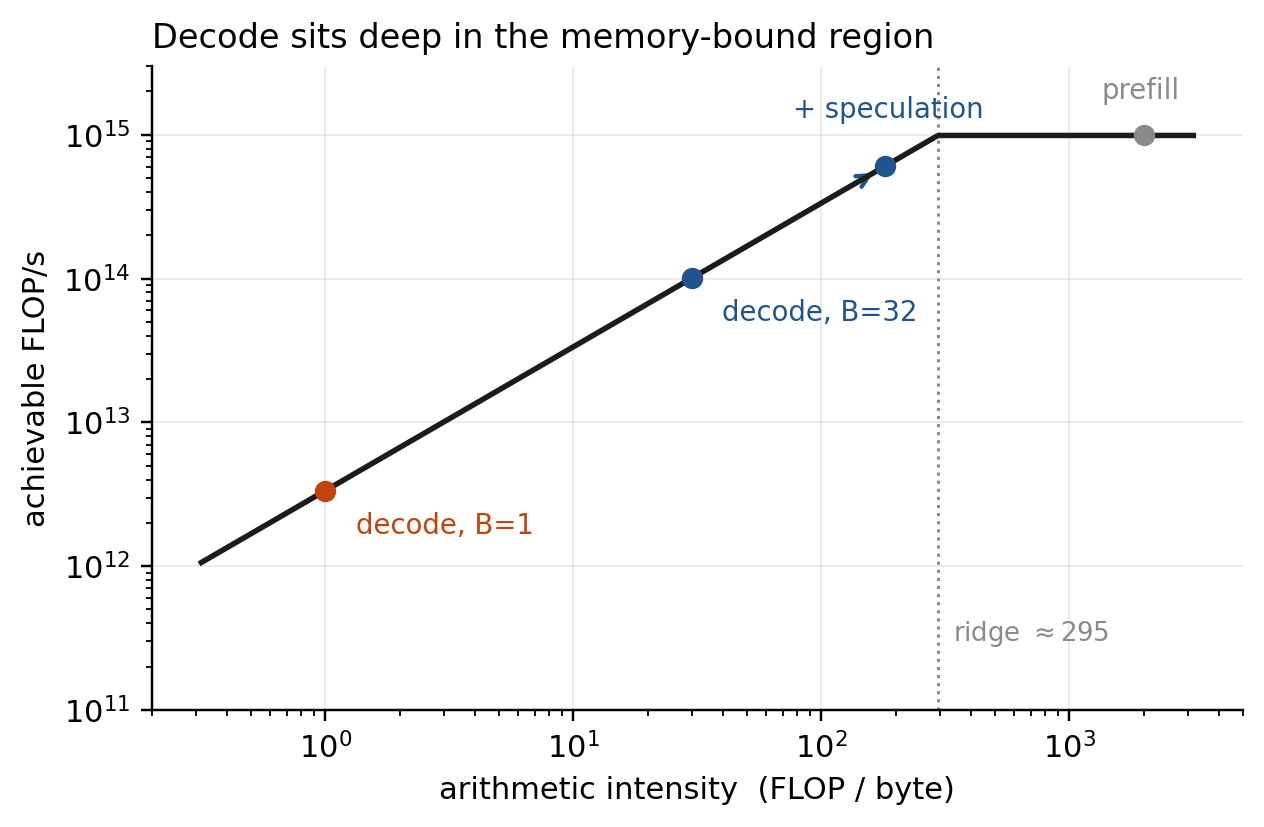
드래프트(draft)로 뽑은 토큰 개를 순전파 한 번으로 검증하면 위치(position)는 개가 되고, 가중치 읽기량은 그대로인 채 연산 강도(arithmetic intensity)만 그만큼 올라갑니다. 메모리 바운드 구간에서는 이것이 거의 공짜이고, 이 글의 나머지 내용은 전부 이 사실 하나에서 출발합니다.
대부분의 가속 기법은 단계 하나를 싸게 만드는 쪽입니다. 양자화(quantization)와 희소성(sparsity)은 가중치당 바이트 수를 줄이고, 배치를 키우면 가중치 읽기 비용이 여러 요청으로 나눠지고, 더 좋은 커널(kernel)은 상수 항을 깎습니다. 하지만 어느 것도 순차 실행 구조 자체는 건드리지 않습니다.
추측은 접근이 다릅니다. 순차 의존성 자체를 공격하는 데다, 위 기법들 중 유일하게 정확한 무손실(lossless)이 가능하기 때문입니다.
알고리즘
구조는 간단합니다. 싼 드래프터가 토큰 개를 제안하면, 타깃(target)이 순전파 한 번으로 개 위치를 한꺼번에 검사하고, 유효한 가장 긴 접두부(prefix)만 확정합니다.
# one speculative cycle
#   prefix x[:i], speculation length gamma
#   M_t = target, M_d = drafter

# --- draft phase: gamma sequential cheap steps ---
for j in range(gamma):
    q[i+j]  = M_d(prefix=x[:i] + draft[:j])
    draft[j] = sample(q[i+j])

# --- verify phase: ONE target pass over gamma+1 positions ---
p[i : i+gamma+1] = M_t(x[:i] + draft, causal_mask=True)

r = uniform(0, 1, size=gamma)
n = first_index_where(r > p[i+j][draft[j]] / q[i+j][draft[j]])   # or gamma

emit(draft[:n])                                   # n accepted tokens
if n < gamma:
    emit(sample(normalize(relu(p[i+n] - q[i+n]))))  # corrected token
else:
    emit(sample(p[i+gamma]))                        # free bonus token

truncate_kv_cache(to=len_emitted)
여기서 두 가지를 눈여겨볼 필요가 있습니다. 먼저 개의 비율 검사(ratio test)는 타깃 순전파 한 번 뒤에 전부 병렬로 실행되기 때문에 검증(verification)에는 순차 의존성이 없는데, 사실 이것이 이 알고리즘의 핵심입니다. 그리고 거절(rejection)이 나더라도 수정된 토큰 하나는 반드시 나오므로 이고, 추측 때문에 생성이 멈추는 일은 없습니다.
아이디어 자체는 CPU의 분기 예측(branch prediction)에서 왔지만, 실무에서는 두 가지 차이가 중요합니다. CPU의 예측 실패(misprediction)가 정확성 문제라면 LLM의 거절은 통계 문제라서, 드래프트로 뽑힌 토큰이 텍스트로는 완전히 자연스러워도 분포가 맞지 않으면 거절됩니다. 검사 기준이 정확성이 아니라 분포의 일치이기 때문입니다. 또 하나, CPU의 파이프라인 플러시(pipeline flush)는 원래 싸지만 LLM의 롤백(rollback)이 싼 것은 KV 캐시가 추가 전용(append-only)이기 때문인데, 이 전제는 순환 상태 레이어(recurrent-state layer)나 선형 어텐션 레이어(linear-attention layer)에서는 깨집니다.
수락 규칙
드래프터에서 를 뽑고, 확률 로 받아들입니다. 거절되면 정규화한 잔차(residual)에서 대체 토큰을 뽑습니다:
직관적으로 보면 는 어떤 토큰에는 확률을 너무 많이 주고 어떤 토큰에는 너무 적게 주는데, 비율 검사가 그 초과분을 제거하고 잔차가 부족분을 다시 채우는 구조입니다.
정리(무손실성). 최종 출력 토큰은 정확히 를 따릅니다.
증명. 로 둡니다. 수락(acceptance) 경로의 기여는 이고, 거절 경로의 기여는 인데 정규화 상수가 정확히 라서 가 됩니다. 두 경로를 더하면:
이 증명이 의 어떤 성질도 사용하지 않는다는 점이 중요합니다. 이 사실 하나가 설계 공간(design space) 전체를 열어줍니다. n-gram 표든 접미사 오토마톤(suffix automaton)이든 확산(diffusion) 모델이든, 양자화한 네트워크나 레이어 절반을 건너뛴 타깃까지도 전부 드래프터가 될 수 있고, 전부 무손실이며, 정확성 증명은 그대로입니다.
그래서 드래프터를 개선하는 일은 전부 효율 개선입니다. 무손실 계열 안에는 품질 트레이드오프라는 것이 존재하지 않습니다.
수락률에는 닫힌 형태(closed form)도 있습니다:
Leviathan et al. (2023)의 이 항등식은 시스템 질문(빠른 경로(fast path)가 얼마나 자주 실행되는가)을 통계 질문(두 분포가 에서 얼마나 가까운가)으로 바꿔놓습니다. 원 논문은 이 거리를 라는 자체 표기로 부르고, 접두부 하나에 대한 수락 확률과 그 기댓값을 다른 기호로 구분합니다. 덕분에 드래프터 학습은 최적 목적함수(optimal objective)가 알려진, 잘 정의된 최적화 문제가 되고, 이 글의 나머지도 감이 아니라 계산으로 진행할 수 있습니다.
자주 틀리는 따름정리(corollary)가 두 개 있습니다. top-1 일치율은 온도(temperature) 0이 아닌 한 가 아닙니다. 그리고 는 원래 위치마다 다른 값이라서, 어딘가에서 인용된 숫자 하나는 명시되지 않은 컨텍스트(context) 조합에 대한 평균일 뿐입니다.
속도 향상을 결정하는 방정식
수락이 i.i.d. 라 가정하고 드래프터의 상대 비용을 로 정의하면, 여기서 는 드래프트 단계 하나가 아니라 토큰 개를 뽑는 드래프트 단계 전체의 시간입니다. 사이클당 기대 토큰 수는 절단 기하분포(truncated geometric)로 떨어집니다:
사이클 하나의 비용이 이니, 둘을 나누면 속도 향상 방정식이 나옵니다. 이것도 같은 논문에 있습니다:
파라미터는 , , 세 개뿐입니다. 그리고 투기적 디코딩 논문 대부분은 다음 네 항 중 하나를 움직이는 것으로 정리됩니다:
| 레버 | 하는 일 | 예시 |
|---|---|---|
| 드래프터의 분포 를 타깃의 분포 에 가깝게 만들어서 수락 확률을 올립니다. | EAGLE, DistillSpec, MTP | |
| 타깃 대비 드래프트 비용을 낮춰서 사이클당 오버헤드를 줄입니다. | FR-Spec, MagicDec, 병렬 드래프터 | |
| 재배분 | 같은 드래프트 예산(budget)을 체인 대신 트리 같은 다른 구조에 씁니다. | SpecInfer, Sequoia, EAGLE-2 |
| 규칙 변경 | 수락 판정 기준 자체를 완화합니다. 무손실 보장은 포기합니다. | typical acceptance, Judge, SpecTr |
하나씩 풀어보면 이렇습니다. 첫 번째 레버(lever)는 드래프터를 더 정확하게 만드는 것입니다. 이므로 드래프터의 분포가 타깃의 분포에 가까울수록 드래프트가 받아들여질 확률이 올라갑니다. 두 번째는 드래프터를 더 싸게 만드는 것입니다. 같은 라도 드래프트에 드는 시간이 줄면 사이클당 비용이 내려가서 속도 향상이 커집니다. 세 번째는 드래프트 예산은 그대로 두고 구조를 바꾸는 것으로, 토큰 개를 일렬로 뽑는 대신 트리 형태로 여러 후보를 뽑는 방식입니다. 아래에서 따로 다룹니다. 마지막은 수락 판정 기준 자체를 바꾸는 것인데, 무손실 보장을 포기하는 대가가 따릅니다.
여기서 결론이 세 개 나옵니다.
상한이 있고, 그 상한은 가 정합니다.
드래프터가 싸지 않으면 아무리 정확해도 소용없다는 뜻입니다. 단 쪽은 을 전제하는데, 드래프터라고 부를 만한 것이라면 항상 성립합니다.
속도 향상은 자동이 아닙니다. 에서 이라, 가 아니면 추측은 오히려 느립니다. 타깃의 절반 비용인 드래프터라면 절반 이상은 맞혀야 본전인 셈입니다.
와 는 묶여 있습니다. 최적 가 와 함께 커지고 와 함께 작아지기 때문에, 둘을 따로 조정할 수는 없습니다.
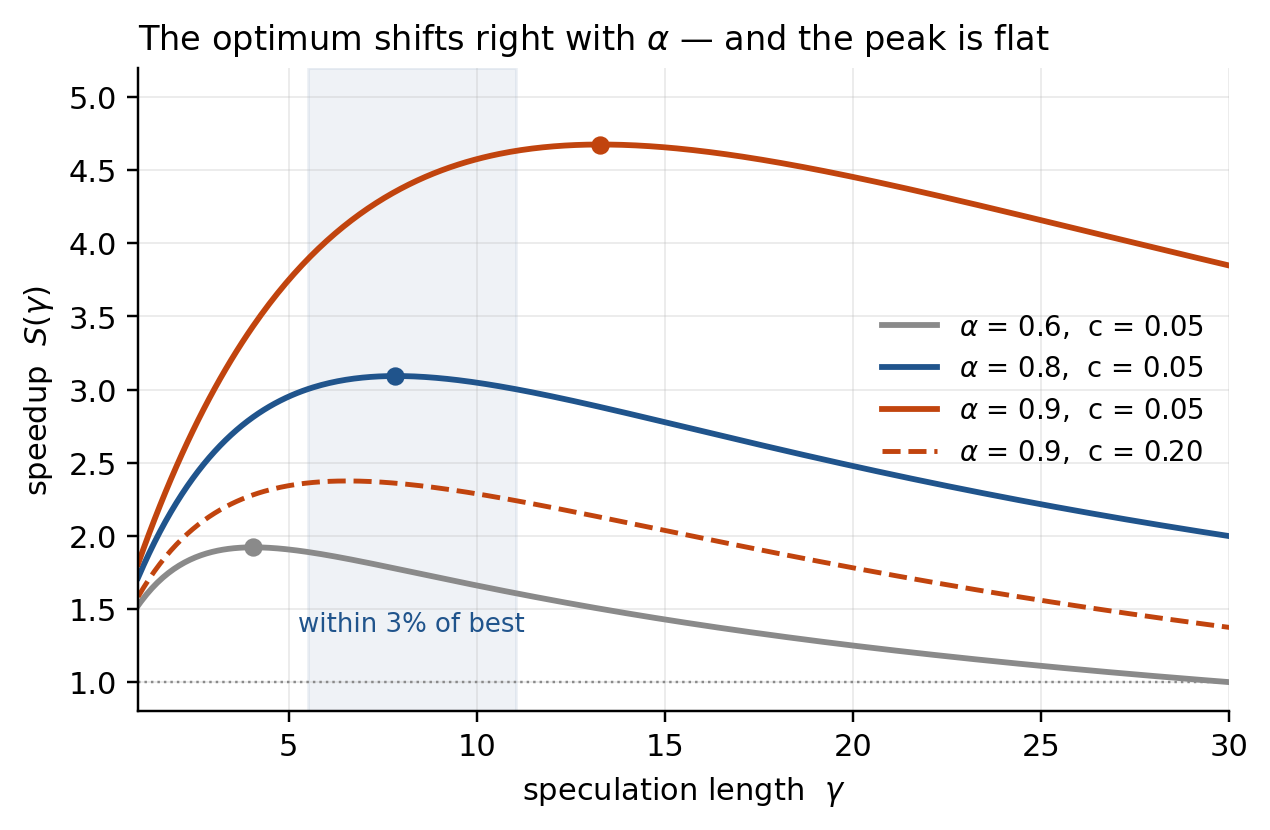
이 그림에서 읽을 점은 두 가지입니다. 가 커질수록 최대가 오른쪽으로 이동한다는 것, 그리고 곡선이 꽤 평평하다는 것입니다. 이고 일 때는 가 6에서 11 사이 어디에 있든 최적값의 3% 이내입니다. 그래서 를 정확히 맞추는 것보다 와 를 제대로 만드는 것이 훨씬 중요하고, 적응형 스케줄러의 가치도 를 정밀하게 찾는 데 있는 것이 아니라 가 지나치게 큰 구간을 피하게 해주는 데 있습니다.
을 풀면 다음 조건이 나오는데,
좌변이 에 대해 엄격히 감소(strictly decreasing)라 는 단봉형(unimodal)입니다. 를 탐욕(greedy) 방식으로 탐색하는 스케줄러 입장에서는 좋은 소식입니다.
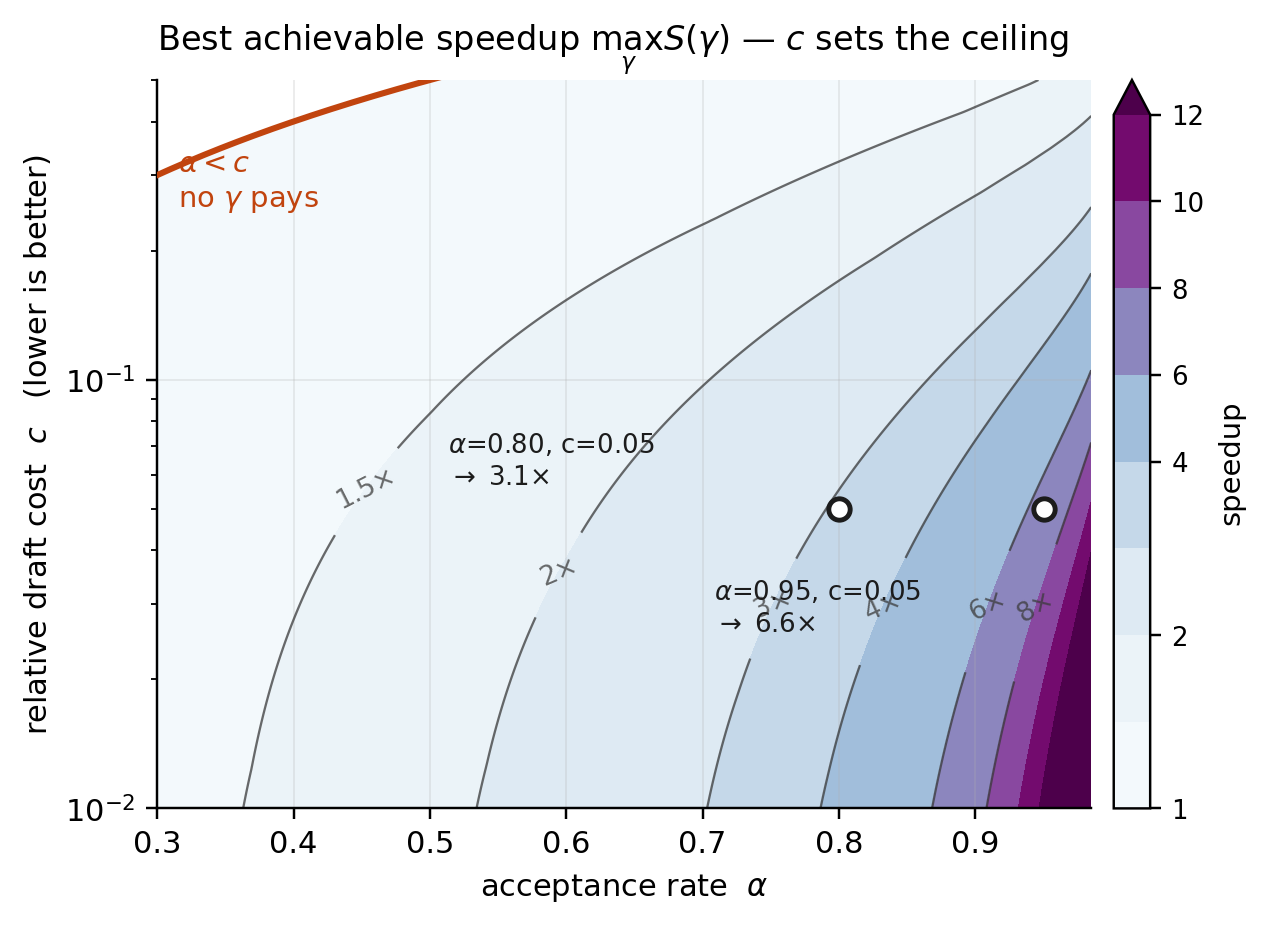
이 그림이 상한을 구체적으로 보여줍니다. 축을 따라 이동해서 얻는 것보다 축을 따라 내려가서 얻는 것이 크고, 선 아래에서는 어떤 를 골라도 소용없습니다.
실제 도달점이 상한에서 얼마나 떨어져 있는지도 봐야 합니다. 면 상한은 이지만, 를 달성해도 최대 ()이고 이면 에 그칩니다. 상한은 어디까지나 한계이지 목표가 아닙니다.
재배분: 체인 대신 트리
다음 주제로 넘어가기 전에 레버 하나만 더 보겠습니다. 재배분이란 스칼라 를 구조로 바꾸는 것을 말합니다. 토큰 개짜리 체인 하나 대신 후보 후속 시퀀스(continuation)들의 트리를 드래프트로 뽑고, 각 가지가 자기 조상 노드만 참조하도록(causal) 마스크를 걸어 타깃 순전파 한 번으로 여러 체인을 검증하는 방식입니다. 예산은 그대로 두고 쓰는 구조만 바꾸는 것입니다.
트리 모양을 고르는 데는 깔끔한 답이 있습니다. 각 노드를 생존 확률(survival probability) , 즉 그 노드까지 도달하고 수락까지 될 확률로 평가해서 전체에서 top-을 고르면 됩니다. 는 루트에서 내려갈수록 감소만 하므로, 동점일 때 얕은 쪽을 먼저 고르기만 하면 이 탐욕 선택은 접두부에 대해 닫혀 있고(prefix-closed), 짧은 귀납법으로 고정 예산에서 최적임을 보일 수 있습니다. 같은 논리가 트리 노드, 블록 안의 드래프트 위치, 배치 안의 요청이라는 세 가지 인덱스 집합(index set)에서 그대로 반복되는데, 명제 하나가 트리 구성과 드래프트 길이 선택, 배치 스케줄링까지 전부 커버하는 이유가 여기에 있습니다. 다만 이 명제가 정하는 건 주어진 예산을 어떻게 쓰느냐이지, 예산을 얼마로 잡느냐가 아닙니다.
추측은 왜 연산을 더 쓸까요?
는 실제 경과 시간(wall-clock) 기준의 명제라서, 추가로 검증하는 토큰이 공짜라는 가정이 깔려 있습니다. 이 가정은 메모리 바운드 구간에서만 성립합니다.
Leviathan et al.은 같은 논문에서 두 번째 정리(theorem)를 제시하는데, 이번에는 실제 경과 시간 시간이 아니라 연산량 기준입니다. 드래프터의 연산량 비율을 라 하면 전체 연산량의 기대 증가율이 다음과 같습니다:
투기적 디코딩은 아끼는 것보다 많은 연산을 쓰는 기법입니다. 연산을 소모해서 지연 시간을 줄이는 구조인 것입니다.
그래서 고정된 부하에서 토큰 생성 시간(time-to-token)을 최적화하는 상황이라면 가 기준이고 추측은 이득이지만, 포화 상태에서 초당 토큰 수를 최적화하는 상황이라면 위 식이 기준이고 추측은 비용입니다. 두 해석 모두 맞습니다. 둘 중 하나만 보고하는 벤치마크로는 도입 여부를 판단할 수 없다는 것이 문제일 뿐입니다.
프로덕션(production)에서도 그대로 나타납니다. DeepSeek의 하드웨어 회고(hardware retrospective)에는 MTP가 처리량(throughput)을 약간 떨어뜨리는 대신 전체 지연 시간(end-to-end latency)을 크게 개선했다는 기록이 있는데, 연산량 정리가 대규모 환경에서 관측된 사례라고 볼 수 있습니다.
VESSL AI가 측정한 것
VESSL AI는 GLM-5.2, MiniMax-M3 등 여러 오픈소스 모델을 VESSL Cloud에서 투기적 디코딩을 적용해 프로덕션으로 서빙하고 있는데, 돌아오는 숫자는 드래프터보다 측정 지점에 더 크게 좌우됩니다.
예를 하나 보겠습니다. Solar-Open2-250B에 DSpark 드래프터를 붙인 구성을 일반 자기회귀 디코딩(autoregressive decoding)과 비교해서, 여섯 개 동작점에서 각각 3회씩 측정했을 때입니다.
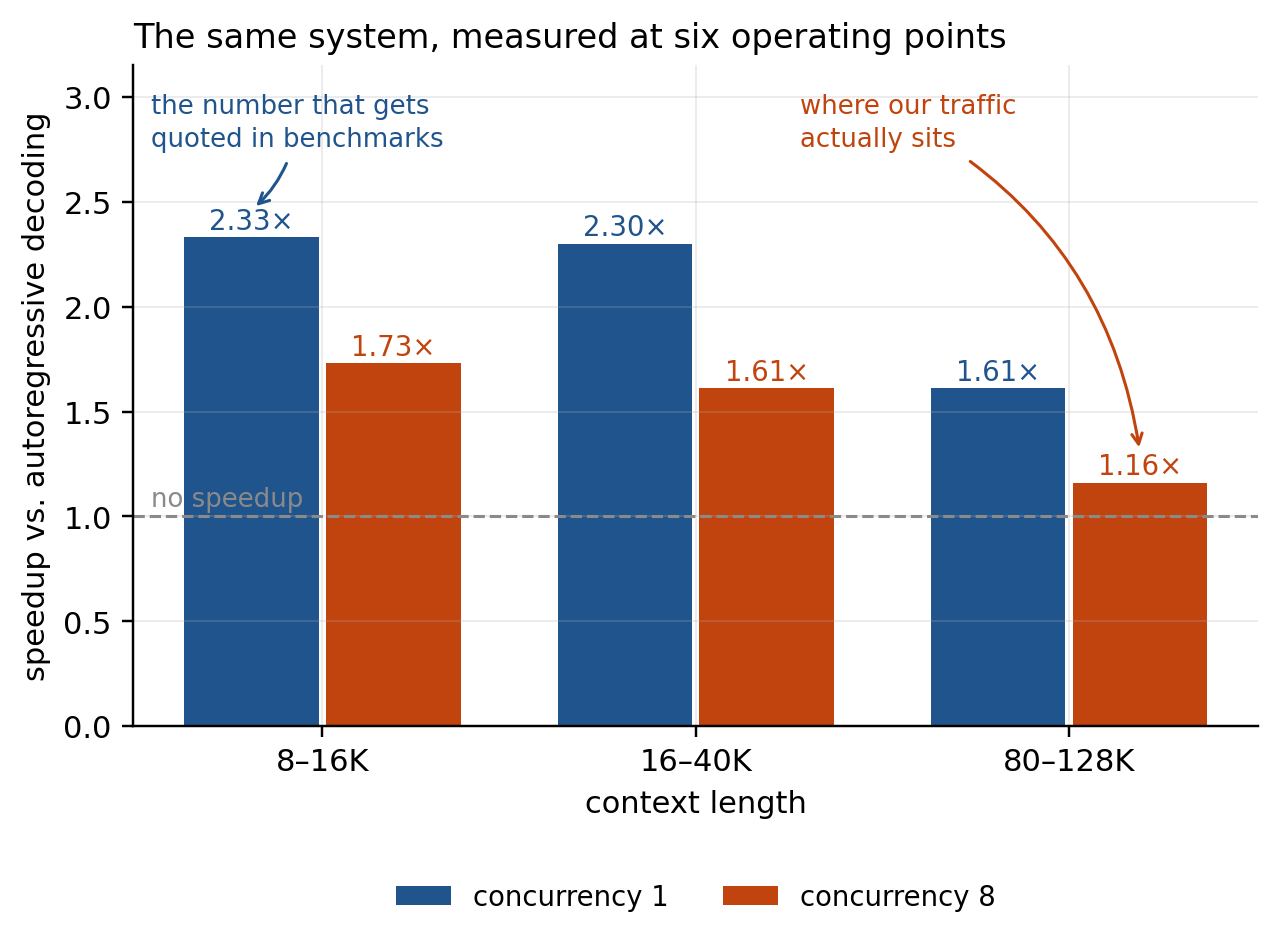
축이 두 개인데 효과는 곱으로 작용합니다. 동시 요청 수를 1에서 8로 올리면 약 26%를 잃고, 컨텍스트를 8~16K에서 80~128K로 늘리면 약 31%를 잃어서, 둘이 겹치면 2.33×가 1.16×까지 내려갑니다.
왼쪽 위 칸과 오른쪽 아래 칸 사이에서 드래프터는 아무것도 바뀌지 않았습니다. 두 숫자 모두 정확한 측정값인데, 실제 배포 환경을 설명하는 것은 둘 중 하나뿐입니다.
같은 기법이 조건에 따라 빨라지기도, 느려지기도 합니다
같은 드래프터 계열을 GLM-5.2에 붙이면 단일 스트림(single-stream) 요청에서 2.99×가 나옵니다. 평균 수락 길이(mean accepted length) 4.44로 모델 내장 MTP 헤드(head)의 1.93보다 높습니다. 그런데 동시 요청 수를 64로 올리면 수락은 유지되는데 속도 향상이 따라오지 못합니다. 부하가 일정 수준을 넘으면 추가 검증 연산이 아낀 순전파보다 비싸지기 때문입니다.
앞에서 본 두 번째 정리가 프로덕션에서 이렇게 나타납니다. 추측은 연산을 소모해서 지연 시간을 줄이는 기법이라, 연산이 가장 부족한 자원인 상황에서는 소모할 것 자체가 없는 것입니다.
측정에 사용한 드래프터, DSpark
위 측정에 등장한 드래프터가 DSpark입니다. DeepSeek-AI가 베이징대와 함께 발표하고 자사 서빙 스택에 적용한 방식이고, Solar-Open2-250B와 GLM-5.2에 붙인 것도 각 타깃에 맞춰 학습한 같은 계열입니다.
DSpark는 병렬 드래프터입니다. 토큰 개를 하나씩 순서대로 뽑는 대신 순전파 한 번으로 드래프트 블록 전체를 채우는데, 이 백본(backbone)은 DSpark가 새로 만든 것이 아니라 DFlash에서 가져온 것입니다. 드래프트가 순전파 하나로 끝나므로 가 작아지고, 앞의 방정식에서 본 대로 상한 가 올라갑니다.
병렬 드래프트의 약점은 위치들이 서로를 보지 못한다는 점입니다. 각 위치가 자기 앞 토큰이 실제로 무엇으로 뽑혔는지 모른 채 독립적으로 예측하기 때문에, 타깃이 여러 후속 시퀀스 사이에서 고민하는 구간에서는 앞뒤가 맞지 않는 조합이 나와 수락이 떨어집니다. DSpark는 여기에 가벼운 순차 보정을 얹어서 직전 토큰에 따라 각 위치의 로짓(logits)을 조정합니다. 보정 비용이 임베딩 조회(embedding lookup) 수준이라 는 거의 그대로인데, 블록 안의 일관성이 복원되면서 가 올라갑니다.
마지막 조각은 스케줄링입니다. DSpark는 위치마다 드래프트가 거기까지 살아남을 확률을 함께 예측하고, 배치 안의 모든 요청에 대해 이 확률이 높은 순서로 검증 예산을 배분합니다. 가 고정 하이퍼파라미터가 아니라 요청마다, 그리고 부하에 따라 정해지는 값이 되는 것입니다. 위에서 본 것처럼 속도 향상이 동작점에 따라 크게 달라지기 때문에, 프로덕션에서는 이 조각이 드래프터 자체만큼 중요합니다.
정리
투기적 디코딩은 파라미터 세 개와 상한이 있는 방정식 하나로 정리됩니다. 자신의 와 , 그리고 실제로 서빙하는 부하를 알고 있다면, 새 논문의 초록만 읽고도 네 항 중 무엇을 움직이는지 파악해서 코드를 쓰기 전에 이득을 추정할 수 있습니다.
그리고 동작점 없이 인용된 속도 향상은 결과가 아니라 표의 칸 하나일 뿐입니다.
남은 질문은 로 전부 되갚지 않으면서 를 올리는 방법입니다. 모든 드래프터 아키텍처가 이 질문에 대한 각자의 답이고, 차이는 주로 드래프터가 추측을 확정하기 전에 무엇을 볼 수 있느냐에 있습니다.
2편에서는 드래프터 아키텍처가 어떻게 발전했는지 다룹니다.
VESSL AI
뉴스레터 구독
AI 인프라 구축 노하우와 최신 GPU 소식을 매달 보내드려요.