Machine LearningVESSL AI
H100 8장 & Qwen3.5-35B로 금융 LLM 만들기: Full-Weight 레시피
8×H100에서 35B 모델에 시점 기준 이어학습을 돌리고 lookahead 편향(누수 프리미엄)을 측정했어요. 정직한 결과와 재현 레시피.
V
|34분
VESSL AI 팀의 최신 업데이트, 엔지니어링 인사이트, 제품 소식을 전합니다.
8×H100에서 35B 모델에 시점 기준 이어학습을 돌리고 lookahead 편향(누수 프리미엄)을 측정했어요. 정직한 결과와 재현 레시피.
A100·H100·B200에서 Gemma-4-31B LoRA 파인튜닝·추론을 직접 측정했어요. 튜닝하면 토큰당 비용은 약 5% 동률 — 속도와 서빙 용량에선 B 시리즈가 앞서요.
VESSL Cloud A100에서 Gemma 4 E4B를 15분 만에 파인튜닝하는 전체 과정. QLoRA + Unsloth로 VRAM 10GB, 비용 $0.38.
잠든 사이 워크스페이스가 돌며 크레딧이 빠져나가던 경험, 한 번쯤 있으시죠? 배치 잡은 제출하면 자동으로 끝나요. 실패해도 돈이 새지 않는 구조예요.
Blockwise, Medusa, Hydra, EAGLE, MTP, DFlash, DSpark. 드래프터(drafter) 아키텍처의 발전을 드래프트(draft)의 조건화(conditioning) 신호가 어디서 오는가라는 질문 하나로 읽습니다.
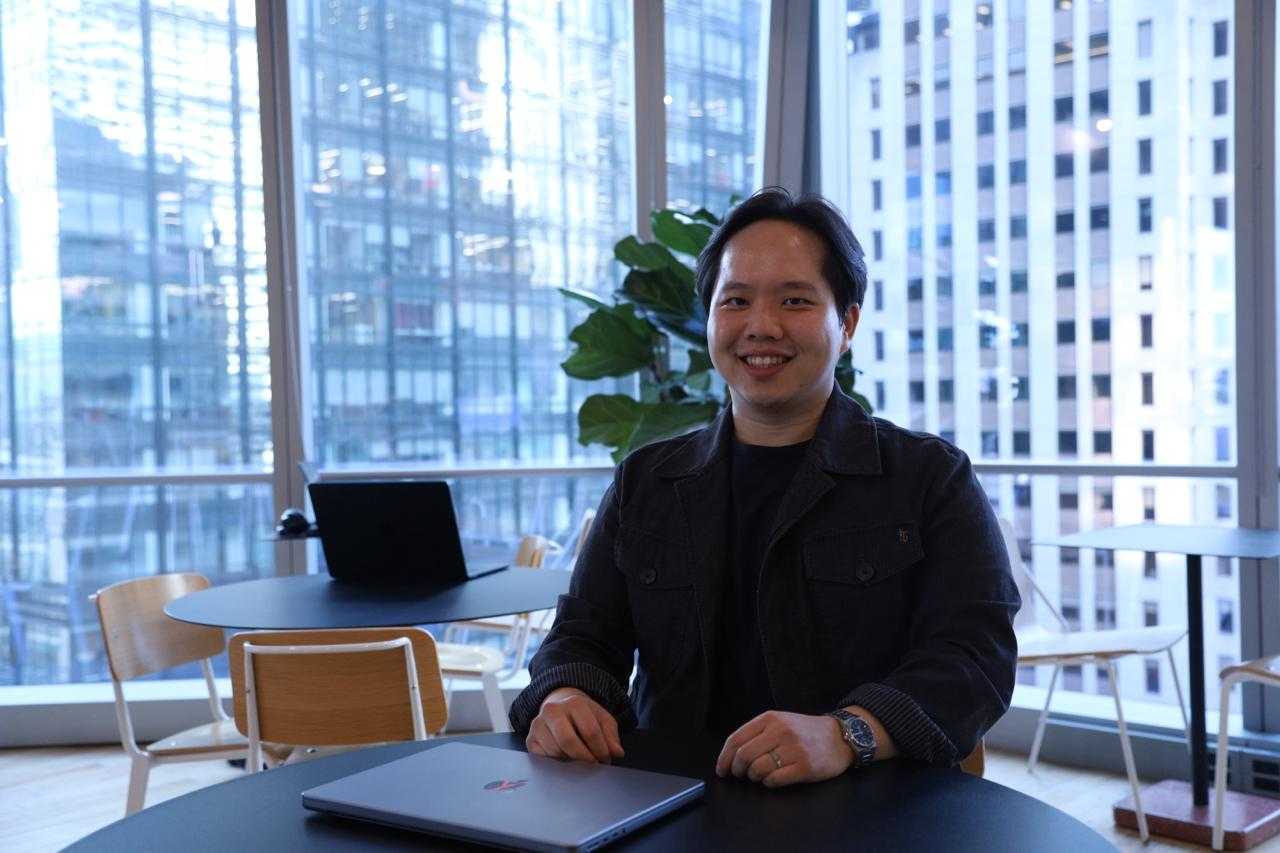
류인태 베슬AI 부사장이 더벨 인터뷰에서 GPU 클라우드의 차별점은 물량이 아니라 운영이라고 말했어요.

토큰 단가는 2,400배 떨어졌지만 작업 1건당 토큰은 그보다 빠르게 늘었어요. 같은 GPU에서 SLO를 지킨 처리량을 2.7배로 끌어올린 VESSL AI의 인퍼런스 최적화 방법과 실제 서비스 운영 전략을 정리했어요.
디코드(decode)는 몇 자릿수 차이로 메모리 바운드(memory-bound) 상태입니다. 닫힌 형태의 방정식 하나로 추측(speculation)이 그 낭비를 얼마나 되찾고 다른 곳에서 무엇을 치르는지 계산할 수 있습니다.
전지환 베슬AI CTO가 IT동아 인터뷰에서 네오클라우드 전환 배경과 플루이드 컴퓨팅, GPU 5만 장·APAC 1위 목표를 이야기했어요.
KT가 16개 기업과 '모두의 AI' 컨소시엄을 출범하고 10월 베타 서비스를 예고했어요. 이음 얼라이언스 운영 구조와, 베슬AI코리아가 맡은 AI 인프라 역할을 정리했어요.
네오에이아이클라우드가 포항 AI데이터센터의 GPU 플랫폼 구축·운영을 베슬AI에 맡겨요. 총사업비 6000억원·수전용량 40MW 규모의 수냉식 데이터센터 사업 전체에서 인프라와 플랫폼을 어떻게 나눠 맡는지 정리했어요.
안재만 베슬AI 대표가 삼성SDS '리얼 서밋 2026'에서 공개한 GPU 클러스터 협업 성과예요. 가동률 35%→90%, 매출 50배 성장 스토리를 정리했어요.
가족의 암 투병을 지켜보며 창업한 안재만 대표가 흩어진 GPU를 묶는 네오클라우드 전략과 2030년 글로벌 톱3 목표를 이야기했어요.
베슬AI가 SK바이오팜에 엔비디아 B200 GPU 128장 규모 컴퓨팅 자원을 공급해요. 16개 노드로 묶인 이 자원이 신약 연구개발과 의료 데이터 기반 파운데이션 모델 사전학습에 어떻게 쓰이는지 정리했어요.
지금 GPU는 가격 협상이 아니라 물량 존재 여부의 문제예요. 사전 확보가 필요한 이유와, 품의서를 통과시키는 5년 TCO 비교 프레임을 웨비나에서 정리했어요.
수천 장에서 수십만 장 규모의 클러스터에서 장애는 없앨 수 있는 변수가 아니라 설계의 전제입니다. 감지, 자동화, SLO 관리라는 세 층위로 장비 증설 없이 SLO를 지킨 처리량을 2.7배로 끌어올린 VESSL AI의 운영 방식을 정리했습니다.