베슬AI 안재만 대표 "AI 팩토리 완성하려면 안정성·효율성·스케일 갖춰야"

핵심 요약
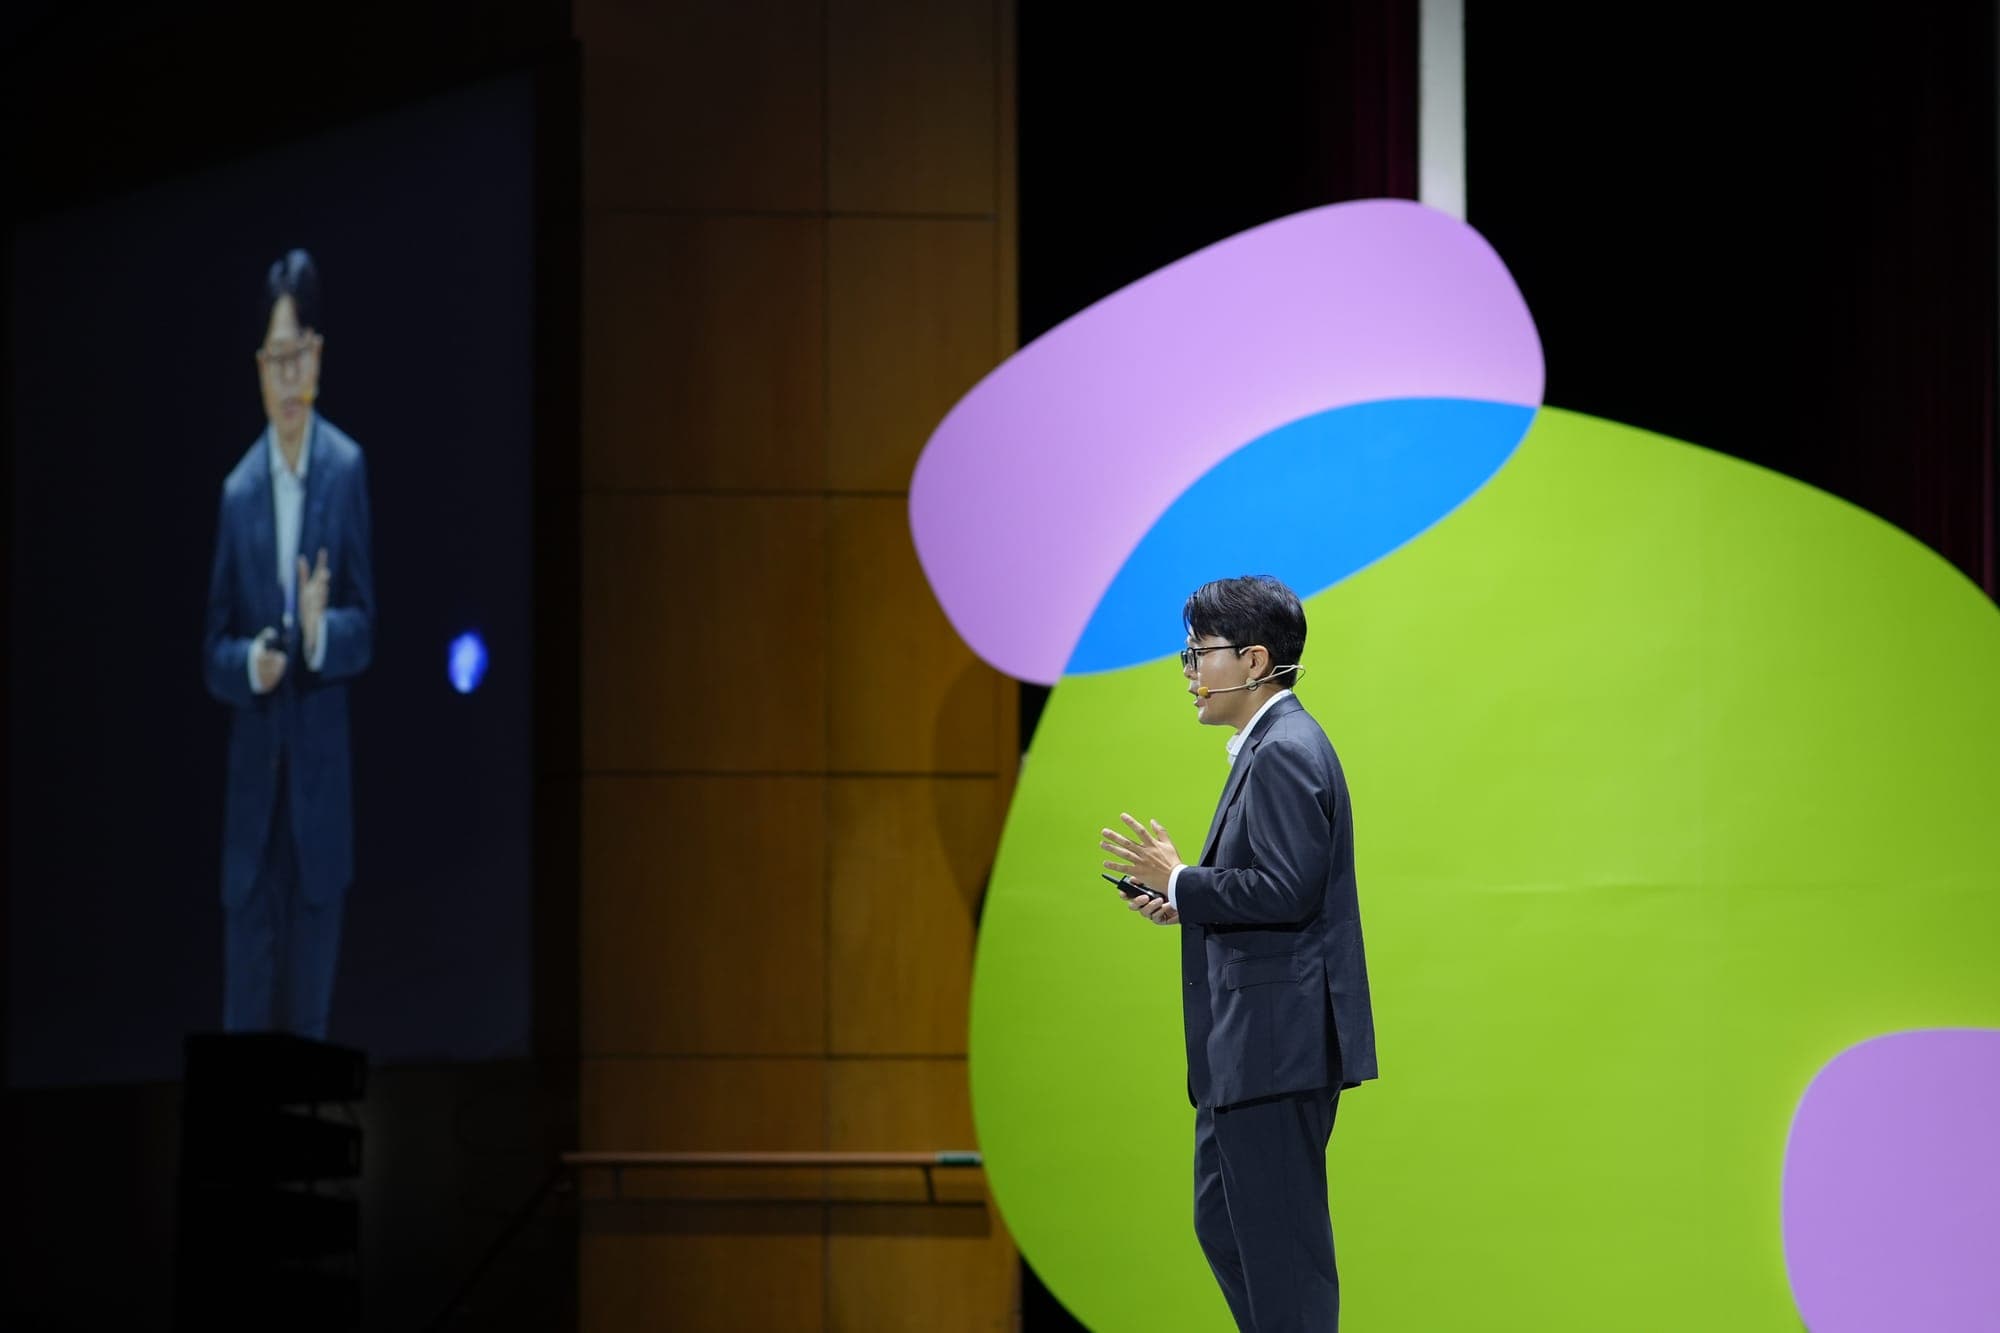
- 안재만 베슬AI 대표가 9월 8일 삼성SDS의 엔터프라이즈 AX 콘퍼런스 '리얼 서밋(REAL Summit) 2026'에서 삼성 클라우드 플랫폼(SCP)과 함께 구축한 AI 팩토리 운영 사례를 공개했어요.
- 베슬AI는 8천장 이상의 GPU로 대규모 학습·추론 인프라를 제공하는 GPU 클라우드 기업이에요.
- 삼성SDS와의 협업으로 GPU 클러스터 가동률을 35%에서 90%까지 끌어올렸고, 그 결과 작년 대비 매출이 50배 이상 늘어 2천억원 이상을 바라보고 있어요.
- 안 대표는 AI 팩토리를 완성하는 조건으로 안정성, 효율성, 스케일 세 가지를 꼽았어요.
이 글은 [삼성SDS 인사이트⑧] 왜 삼성SDS인가? 기사를 바탕으로 VESSL AI에서 정리했어요.
수천 장의 GPU로 몇 달씩 안정적으로 모델을 학습시키는 일은 데이터센터만 잘 지어서 되는 문제가 아니에요. 하드웨어를 들여놓는 것과, 그 하드웨어로 몇 달 동안 끊김 없이 대규모 학습·추론을 돌리는 것 사이에는 또 다른 간극이 있어요. 안재만 베슬AI 대표는 9월 8일 서울 코엑스에서 열린 삼성SDS의 엔터프라이즈 AX 콘퍼런스 '리얼 서밋(REAL Summit) 2026' 무대에 올라, 삼성 클라우드 플랫폼(SCP)과 손잡고 이 간극을 어떻게 메웠는지 공개했어요.
베슬AI는 어떤 회사인가요?
베슬AI는 8천장 이상의 GPU를 바탕으로 대규모 학습과 추론을 운영하는 기업들에게 GPU 클러스터를 제공하는 회사예요. 자체 GPU 클라우드 VESSL Cloud는 Workspace, 배치 Job, VM Cluster로 GPU를 빌려 쓰는 서비스예요. 이번에 공개된 삼성SDS와의 협업은 이 인프라를 실제로 수천 장 규모에서 운영한 결과를 보여주는 사례예요.
고객사는 국내외를 아우르고 있어요. 안 대표는 "대표적인 고객사로는 국내에서 업스테이지와 같은 독자 파운데이션 모델 개발사가 있다"며 "특히 실리콘밸리의 대규모 벤처캐피탈에서 수천억원 이상의 투자를 받은 프론티어 기업들이 저희의 클러스터를 활용하고 있다"고 말했어요.
AI 팩토리를 완성하려면 무엇이 필요한가요?
안 대표는 AI 팩토리와 AI 컴퓨팅을 이루는 요소를 세 가지로 정리했어요. 첫 번째는 데이터센터 전략, 두 번째는 그 위에 올라가는 GPU·서버 하드웨어예요. 하지만 이 두 가지만으로는 충분하지 않다는 게 그의 진단이에요.
안 대표는 "데이터센터와 AI 팩토리 사이에는 간극이 있다"고 진단했어요. "실제 모델을 개발하고 사용하는 사람 입장에서는 데이터센터가 어디에 있는지, 전력이 얼마나 안정적인지는 그렇게 중요하지 않다"는 거예요. 정작 사용자가 묻는 질문은 따로 있어요. "수천장의 GPU를 가지고 학습을 했을 때 몇 주간 몇 달 동안 안정적으로 돌아가는가, 제한된 GPU 리소스 안에서 얼마나 효율적인 학습 방법론이 만들어지는가, 이러한 과정들이 10장 100장이 아니라 천장 만장의 스케일 안에서도 실행되는가가 가장 중요한 요소"라는 거예요.
여기서 안정성, 효율성, 스케일이라는 세 번째 요소가 나와요. 안 대표는 "이 세 가지가 필수적인 AI 팩토리의 요소"라고 설명했어요.
삼성SDS와 협력해 가동률을 어떻게 35%에서 90%로 끌어올렸나요?
결론부터 말하면, 고성능 스토리지와 장애 자동 감지·복구 체계에 워크로드 스케줄링을 결합해서예요. 안 대표는 "천장 이상의 GPU를 사용할 때는 정말 다양한 문제들이 발생한다"며 "수천장의 GPU가 데이터 스토리지로부터 읽어올 때 병목이 발생하기도 하고 수천장의 GPU 중 한 장이라도 죽으면 전체 작업이 중단되기도 한다"고 설명했어요.
역할 분담은 명확했어요. 안 대표는 "삼성SDS의 흔들리지 않는 물리 계층과 안정적인 데이터센터, 전력과 냉각에 대한 운영뿐만 아니라 대규모 학습과 추론에 맞춘 AI 인프라 설계가 물리적 계층을 완성했다"며 "베슬AI는 그 위에서 자동으로 장애를 인지하고 복구하는 시스템과 네트워크 토폴로지에 맞춘 AI 워크로드 스케줄링 시스템을 담당했다"고 말했어요. 그 결과 가동률은 35%에서 90%까지 올라갔어요.
효율성 측면에서도 세심한 설계가 필요하다고 강조했어요. 안 대표는 "대규모 학습을 진행할 때는 최신 학습 프레임워크에 맞춰 어느 스텝에서 어떤 네트워크 스위치의 밴드위스가 최저치를 치는지 파악하고 이를 해결해야 한다"며 "네트워크와 스토리지 등 사소한 하나하나의 부분에서 병목들이 발생하고 전체적인 효율성을 감소시킨다"고 말했어요. 그는 "10장을 가지고 추론했을 때와 100장, 천장을 가지고 추론했을 때 각각 아예 다른 종류의 문제들을 풀어야 한다"며 대규모 운영 경험이 있는 클라우드 파트너의 중요성을 강조했어요.
베슬AI는 왜 삼성SDS를 택했나요?
베슬AI는 지금도 20개 이상의 클라우드를 병행해서 쓰고 있어요. 안 대표는 "베슬AI는 지금도 20개 이상의 클라우드를 쓰고 있다"며 "계속 새로운 클라우드를 테스트하고 사용하며 그 클라우드를 사용하는 결정들을 한다"고 말했어요. 그중에서도 그는 "국내뿐만 아니라 국외를 포함해 삼성SDS의 클라우드 서비스는 최고 중의 하나였다"고 평가했어요.
그는 "압도적인 데이터센터 운영과 안정적인 물리적 계층을 바탕으로 대규모 학습과 추론에 맞춰 설계된 AI 워크로드 특화 인프라 설계와 운영 성숙도, 국내 최초 클러스터 운영, 최대 규모 GPU 클러스터에 대한 안정적인 운영이 인상적"이라고 덧붙였어요.
이 협업의 성과는 매출로도 드러났어요. 안 대표는 "실리콘밸리와 한국의 최고의 팀들이 삼성SDS와 베슬AI가 만든 GPU 클러스터를 사용하고 있다"며 "이를 통해 베슬AI는 작년 대비 50배 이상의 성장을 이뤄냈고 지금 현재 2천억원 이상의 매출을 바라보고 있다"고 밝혔어요.
한편 삼성SDS는 국내 최초 AI 전용 데이터센터인 동탄 데이터센터에 이어 국가 AI 컴퓨팅 센터, 구미 AI 데이터센터 구축을 가속화해 전국을 잇는 AI 고속도로를 구축한다는 계획이에요.
안 대표가 발표에서 짚은 안정성·효율성·스케일이라는 세 가지 조건은 GPU 클러스터 도입을 검토하는 기업이라면 한 번쯤 마주치는 질문이기도 해요. 대규모 GPU 운영 경험이 있는 파트너가 필요하다면, 베슬AI와 상담을 통해 조건에 맞는 방법을 확인해 보세요.
자주 묻는 질문
베슬AI가 삼성SDS와 협력해 GPU 클러스터 가동률을 어떻게 35%에서 90%로 끌어올렸나요?
삼성SDS의 고성능 스토리지와 장애 자동 감지·복구 체계에, 베슬AI의 장애 인지·복구 시스템과 네트워크 토폴로지에 맞춘 워크로드 스케줄링을 결합해서예요. 물리 계층은 삼성SDS가, 그 위의 소프트웨어 계층은 베슬AI가 맡는 역할 분담이 핵심이에요.
AI 팩토리를 완성하는 데 필요한 세 가지 조건은 무엇인가요?
안정성, 효율성, 스케일이에요. 몇 주에서 몇 달까지 안정적으로 운영되는지, 제한된 GPU로 얼마나 효율적인 학습이 가능한지, 그리고 이 두 가지가 수십 장이 아니라 수천·수만 장 규모에서도 유지되는지를 함께 봐야 해요.
베슬AI는 어떤 기업인가요?
8천장 이상의 GPU로 대규모 학습·추론 인프라를 제공하는 GPU 클라우드 기업이에요. 업스테이지 같은 국내 파운데이션 모델 개발사부터 실리콘밸리 프론티어 스타트업까지 고객으로 두고 있어요.
삼성SDS와의 협업으로 베슬AI 매출은 얼마나 늘었나요?
작년 대비 50배 이상 늘었고, 2026년 9월 기준 2천억원 이상의 매출을 바라보고 있어요.
GPU 클러스터 도입을 검토하고 있다면 어떻게 시작하면 되나요?
필요한 GPU 규모와 워크로드를 알려주시면 베슬AI 팀이 조건에 맞는 구성을 상담해드려요. 베슬AI에 상담을 신청해 보세요.
이어 읽기
VESSL AI
뉴스레터 구독
AI 인프라 구축 노하우와 최신 GPU 소식을 매달 보내드려요.