전지환 베슬AI CTO "MLOps 넘어 네오클라우드로 사업 강화··· 목표는 APAC 1위"
핵심 요약
- 전지환 VESSL AI(베슬AI) CTO는 베슬AI를 GPU를 빠르게 확보해 공급하고, GPU 인프라 운영과 AI 워크로드 전문성까지 갖춘 '프리미엄 클라우드'라고 소개했어요.
- 2026년 8월 기준 베슬AI의 GPU 운영 규모는 약 7,000장, 계약 금액은 1,300억 원이에요. 목표는 올해 1만 장, 내년 5만 장이에요.
- 수만 장 GPU의 가동 효율을 관리하는 '플루이드 컴퓨팅'과, AI 에이전트가 GPU 작업을 다루게 하는 CLI 'vesslctl'이 기술 차별점이에요.
- 베슬AI는 AMD 인스팅트 GPU, 국산 NPU 등 엔비디아 외 AI 가속기에도 문을 열어두고 있어요.
이 글은 전지환 베슬AI CTO "MLOps 넘어 네오클라우드로 사업 강화··· 목표는 APAC 1위" 기사를 바탕으로 VESSL AI에서 정리했어요.
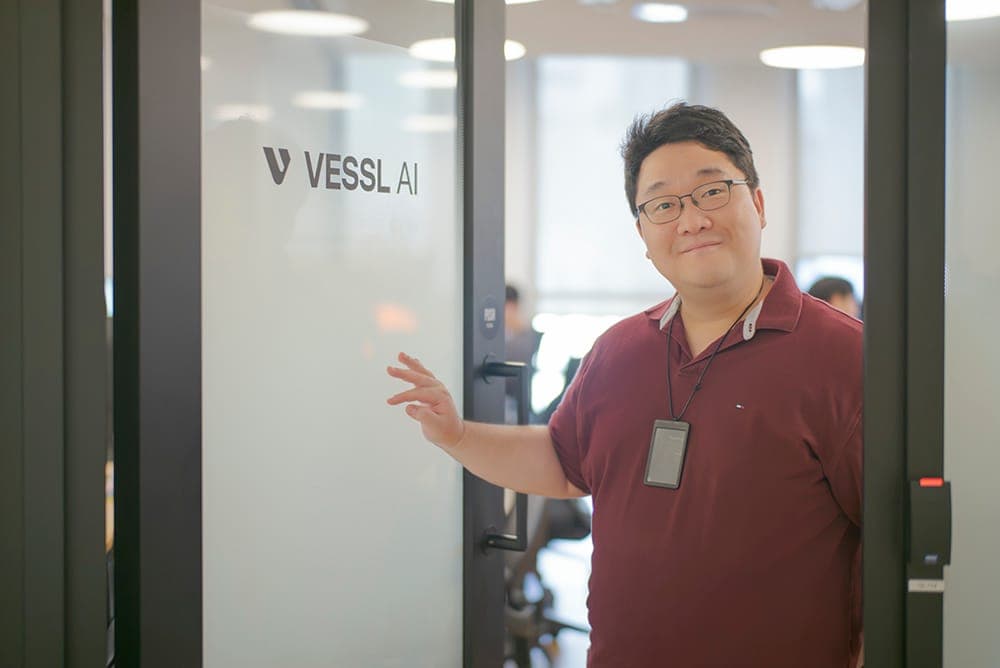
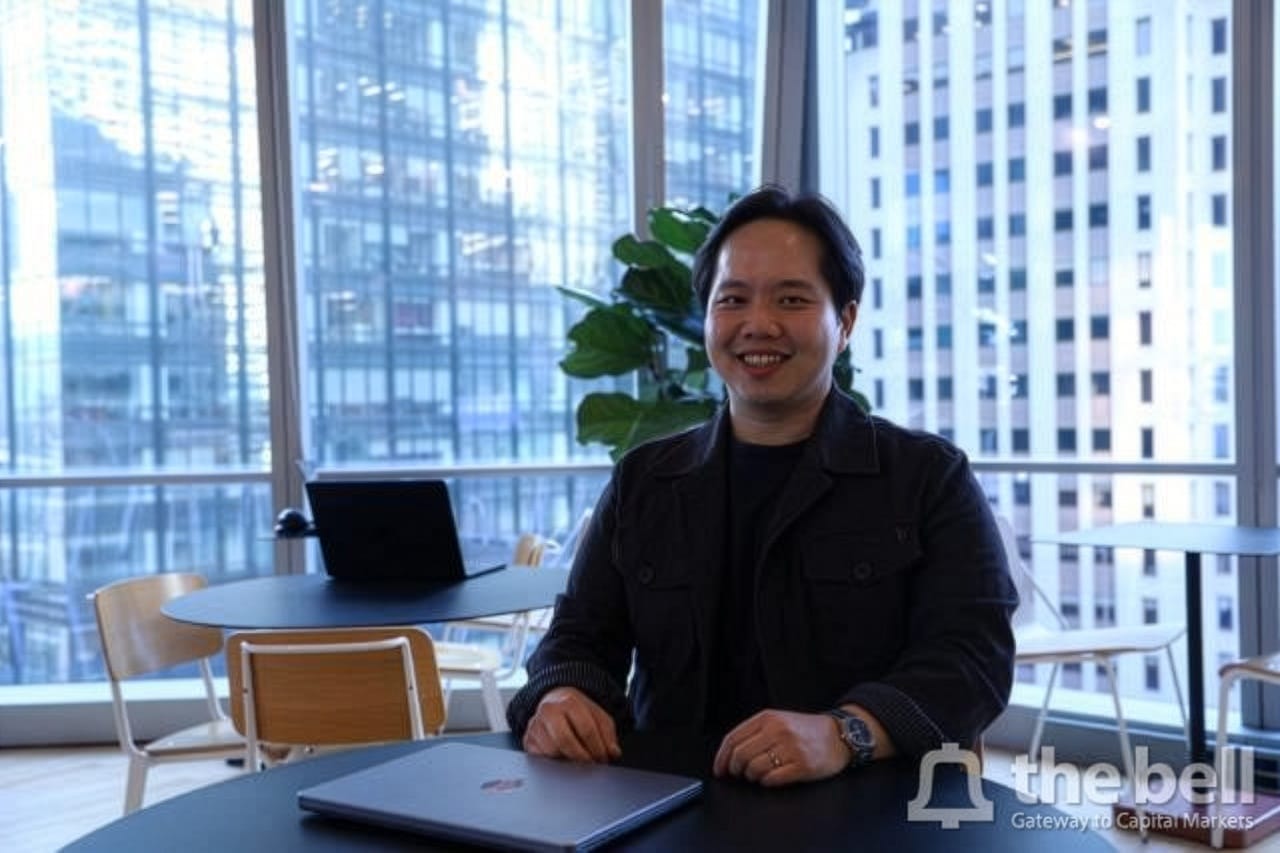
IT동아가 베슬AI 공동창업자인 전지환 CTO를 인터뷰했어요. 전 CTO는 2014년 샌프란시스코의 스타트업에서 경력을 시작해 데브시스터즈, 펍지(현 크래프톤), 구글 사이트 신뢰성 엔지니어를 거쳤어요. 구글에서 수억 명의 사용자 트래픽을 다루며 인프라의 병목은 결국 컴퓨팅 자원 관리에서 온다고 보게 됐고, 2020년 안재만 대표 등과 함께 베슬AI를 창업했어요.
베슬AI는 왜 MLOps에서 네오클라우드로 사업을 넓혔나요?
MLOps 사업은 성장했지만 수익성이 문제였어요. 베슬AI는 기계학습 모델의 개발·배포·운영을 자동화하는 MLOps로 출발했고, 2023년에는 VESSL Run으로 LLM 학습·배포를 관리하는 LLMOps까지 넓혔어요. 하지만 이탈률은 높고 고객 지출은 늘지 않았어요.
돌파구는 2023년부터 학계 연구자를 위해 운영하던 A100 노드 단 4개였어요. 이 노드가 수익을 내는 걸 보고 2025년 11월부터 네오클라우드로 사업을 재편했고, 2026년 2월 VESSL Cloud를 공식 출시했어요. VESSL Cloud는 AI 스타트업, 연구 기관, LLM 개발사에 GPU를 빠르게 공급하고 운영까지 맡는 GPU 클라우드예요.
2026년 8월 기준 GPU 운영 규모는 약 7,000장, 계약 금액은 1,300억 원이에요. 베슬AI는 연말까지 2,500억~3,000억 원 수준의 계약을 맺을 예정이에요. 전 CTO는 사업 전환을 이렇게 설명했어요. "대외적으로는 사업이 MLOps에서 네오클라우드로 바뀐 것이라고들 하나 본질은 규모의 차이일 뿐이다."
사후 학습과 추론이 늘면 GPU 인프라에서 무엇이 중요해지나요?
순수 연산 성능만큼 HBM 용량과 메모리 대역폭 병목 관리가 중요해져요. GPT 등장 이후 2년 정도는 대규모 사전 학습이 대세였지만, 이제는 만들어진 모델을 추가로 학습하는 사후 학습과 추론으로 무게가 옮겨가고 있어요.
전 CTO는 "인프라 구동 측면에서도 추론과 사후 학습 비중이 빠르게 늘고 있으며 내년이면 사전학습의 수요를 넘어설 것으로 보인다"고 말했어요. 베슬AI는 이미 사후 학습 팀을 따로 꾸려 고객 기술지원을 하고 있어요.
베슬AI의 플루이드 컴퓨팅은 GPU 가동 효율을 어떻게 높이나요?
플루이드 컴퓨팅은 수만 장 규모의 GPU를 작업 단위로 나눠 배치하고 스케줄링해 가동 효율을 끌어올리는 베슬AI의 자원 관리 방식이에요. 전 CTO는 "네오클라우드 기업에 있어서 단 한 가지의 가장 중요한 지표는 ‘GPU의 가동 효율이 얼마나 높은가’다"라고 강조했어요.
작업을 어디에 둘지는 서빙 비용, 클러스터, 전력 환경, 스케줄링을 함께 따져 정해요. 고객이 리스케줄링을 모르고 지나갈 만큼 작업이 끊기지 않게 이어지는 게 핵심이에요. 사후 학습이 늘어나는 흐름도 유리해요. 전 CTO는 "사후학습은 어느 곳에서 서비스되든 관리할 수 있어서 상대적으로 자유롭게 배치하고 균형을 잡는다"고 설명했어요.
AI 에이전트가 GPU 작업을 관리하면 무엇이 달라지나요?
사람이 손으로 하는 작업이 줄고, 실수로 켜두는 식의 휴먼에러 낭비도 줄어요. 베슬AI는 2026년 4월 VESSL Cloud 공식 CLI인 vesslctl을 내놓았어요. 터미널에서 워크스페이스 생성, 배치 실행, 데이터 업로드, GPU 자원 관리를 자동화하고, MCP(모델 컨텍스트 프로토콜)를 지원해 외부 AI 코딩 에이전트도 GPU 작업을 다룰 수 있어요.
출시 후 실제 사용자 수는 그대로인데 웹 콘솔 이용률은 절반 수준으로 떨어졌어요. 사람이 수동으로 작업하는 빈도도 약 30% 줄었어요. 에이전트는 처음엔 수동 작업보다 시행착오가 3~4배 많지만, 반복하며 패턴을 익혀요. 전 CTO는 "시행착오를 반복하는 것에 따른 낭비는 있어도 휴먼에러에 따른 낭비는 없다"며 "동시 작업을 제한하거나 사용 시간 등의 제약을 잘 걸어두는 식의 하네스 엔지니어링을 권장한다"고 덧붙였어요.
베슬AI는 엔비디아 외에 AMD GPU나 국산 NPU도 지원하나요?
지원할 계획이에요. 전 CTO는 "베슬 클라우드의 문은 모든 AI 가속기에게 열려있다"고 말했어요. 베슬AI는 이미 AMD와 협업하고 있고, AMD 인스팅트 MI350 시리즈와 MI450 계열 헬리오스 랙스케일 도입을 논의하고 있어요.
퓨리오사AI, 리벨리온 같은 국산 가속기도 고효율 추론이 가능하다면 적극 지원할 생각이에요. 랙스케일 수요에도 대비하고 있어요. 전 CTO는 빠르면 내년 1분기에 주요 수요 기업이 랙스케일을 경험하고, 이후 스타트업에도 기회가 돌아갈 것으로 내다봤어요.
GPU 5만 장 확보 다음에 베슬AI가 그리는 그림은 무엇인가요?
연구자가 자원 제약 없이 연구에 집중하는 환경이에요. 전 CTO는 GPU, 메모리, 전력을 3대 병목으로 꼽고 "HBM은 병목 수준을 넘어서 생산량 자체가 시장의 규모를 결정할 것으로 본다"고 진단했어요. 베슬AI는 작은 모델을 효율적으로 운용하는 기술과, KV캐시를 극저비트로 양자화해도 성능을 지키는 기술을 연구하고 있어요.
당장 목표는 올해 GPU 1만 장, 내년 5만 장이에요. 아시아태평양은 물론 글로벌 네오클라우드 경쟁에 뛰어들 수 있는 규모예요. 전 CTO는 "자원이 연구개발의 병목이 되어서는 안된다는 것이 우리같은 회사의 존재 이유다"라고 말했어요.
사후 학습이나 추론 워크로드에 맞는 GPU 구성이 고민이라면 편하게 문의해 주세요. 정확한 사양이 정해지지 않아도 괜찮아요. 지금 돌리는 작업과 기간만 알려주시면 맞는 구성부터 같이 정리해 드릴게요.
자주 묻는 질문
베슬AI(VESSL AI)의 GPU 운영 규모는 어느 정도인가요?
2026년 8월 기준 약 7,000장이에요. 계약 금액은 1,300억 원이고, 올해 1만 장, 내년 5만 장까지 늘리는 게 목표예요.
베슬AI의 플루이드 컴퓨팅은 무엇인가요?
수만 장 규모의 GPU를 작업 단위로 나눠 배치하고 스케줄링해 가동 효율을 높이는 베슬AI의 자원 관리 방식이에요. 서빙 비용, 클러스터, 전력 환경을 함께 따져 작업이 끊기지 않게 이어지도록 해요.
vesslctl은 무엇이고 AI 에이전트와 어떻게 함께 쓰나요?
vesslctl은 VESSL Cloud의 공식 CLI예요. 터미널에서 워크스페이스 생성, 배치 실행, 데이터 업로드, GPU 자원 관리를 할 수 있고, MCP를 지원해 AI 코딩 에이전트가 GPU 작업을 직접 다룰 수 있어요.
VESSL Cloud에서 엔비디아 외 AMD GPU나 국산 NPU도 쓸 수 있나요?
현재 주력은 엔비디아 GPU예요. 베슬AI는 AMD와 협업하며 인스팅트 MI350 시리즈와 MI450 계열 헬리오스 랙스케일 도입을 논의하고 있고, 국산 NPU도 고효율 추론이 가능하다면 지원할 계획이에요.
이어 읽기
VESSL AI
뉴스레터 구독
AI 인프라 구축 노하우와 최신 GPU 소식을 매달 보내드려요.