베슬AI, 업스테이지 '솔라 프로4' 글로벌 추론 운영 맡아
핵심 요약
- 베슬AI가 업스테이지의 거대언어모델 '솔라 프로4'의 글로벌 추론(인퍼런스) 운영을 맡았어요. 한국·유럽·미국 데이터센터의 GPU 서버로 전 세계 이용자의 요청을 처리했어요.
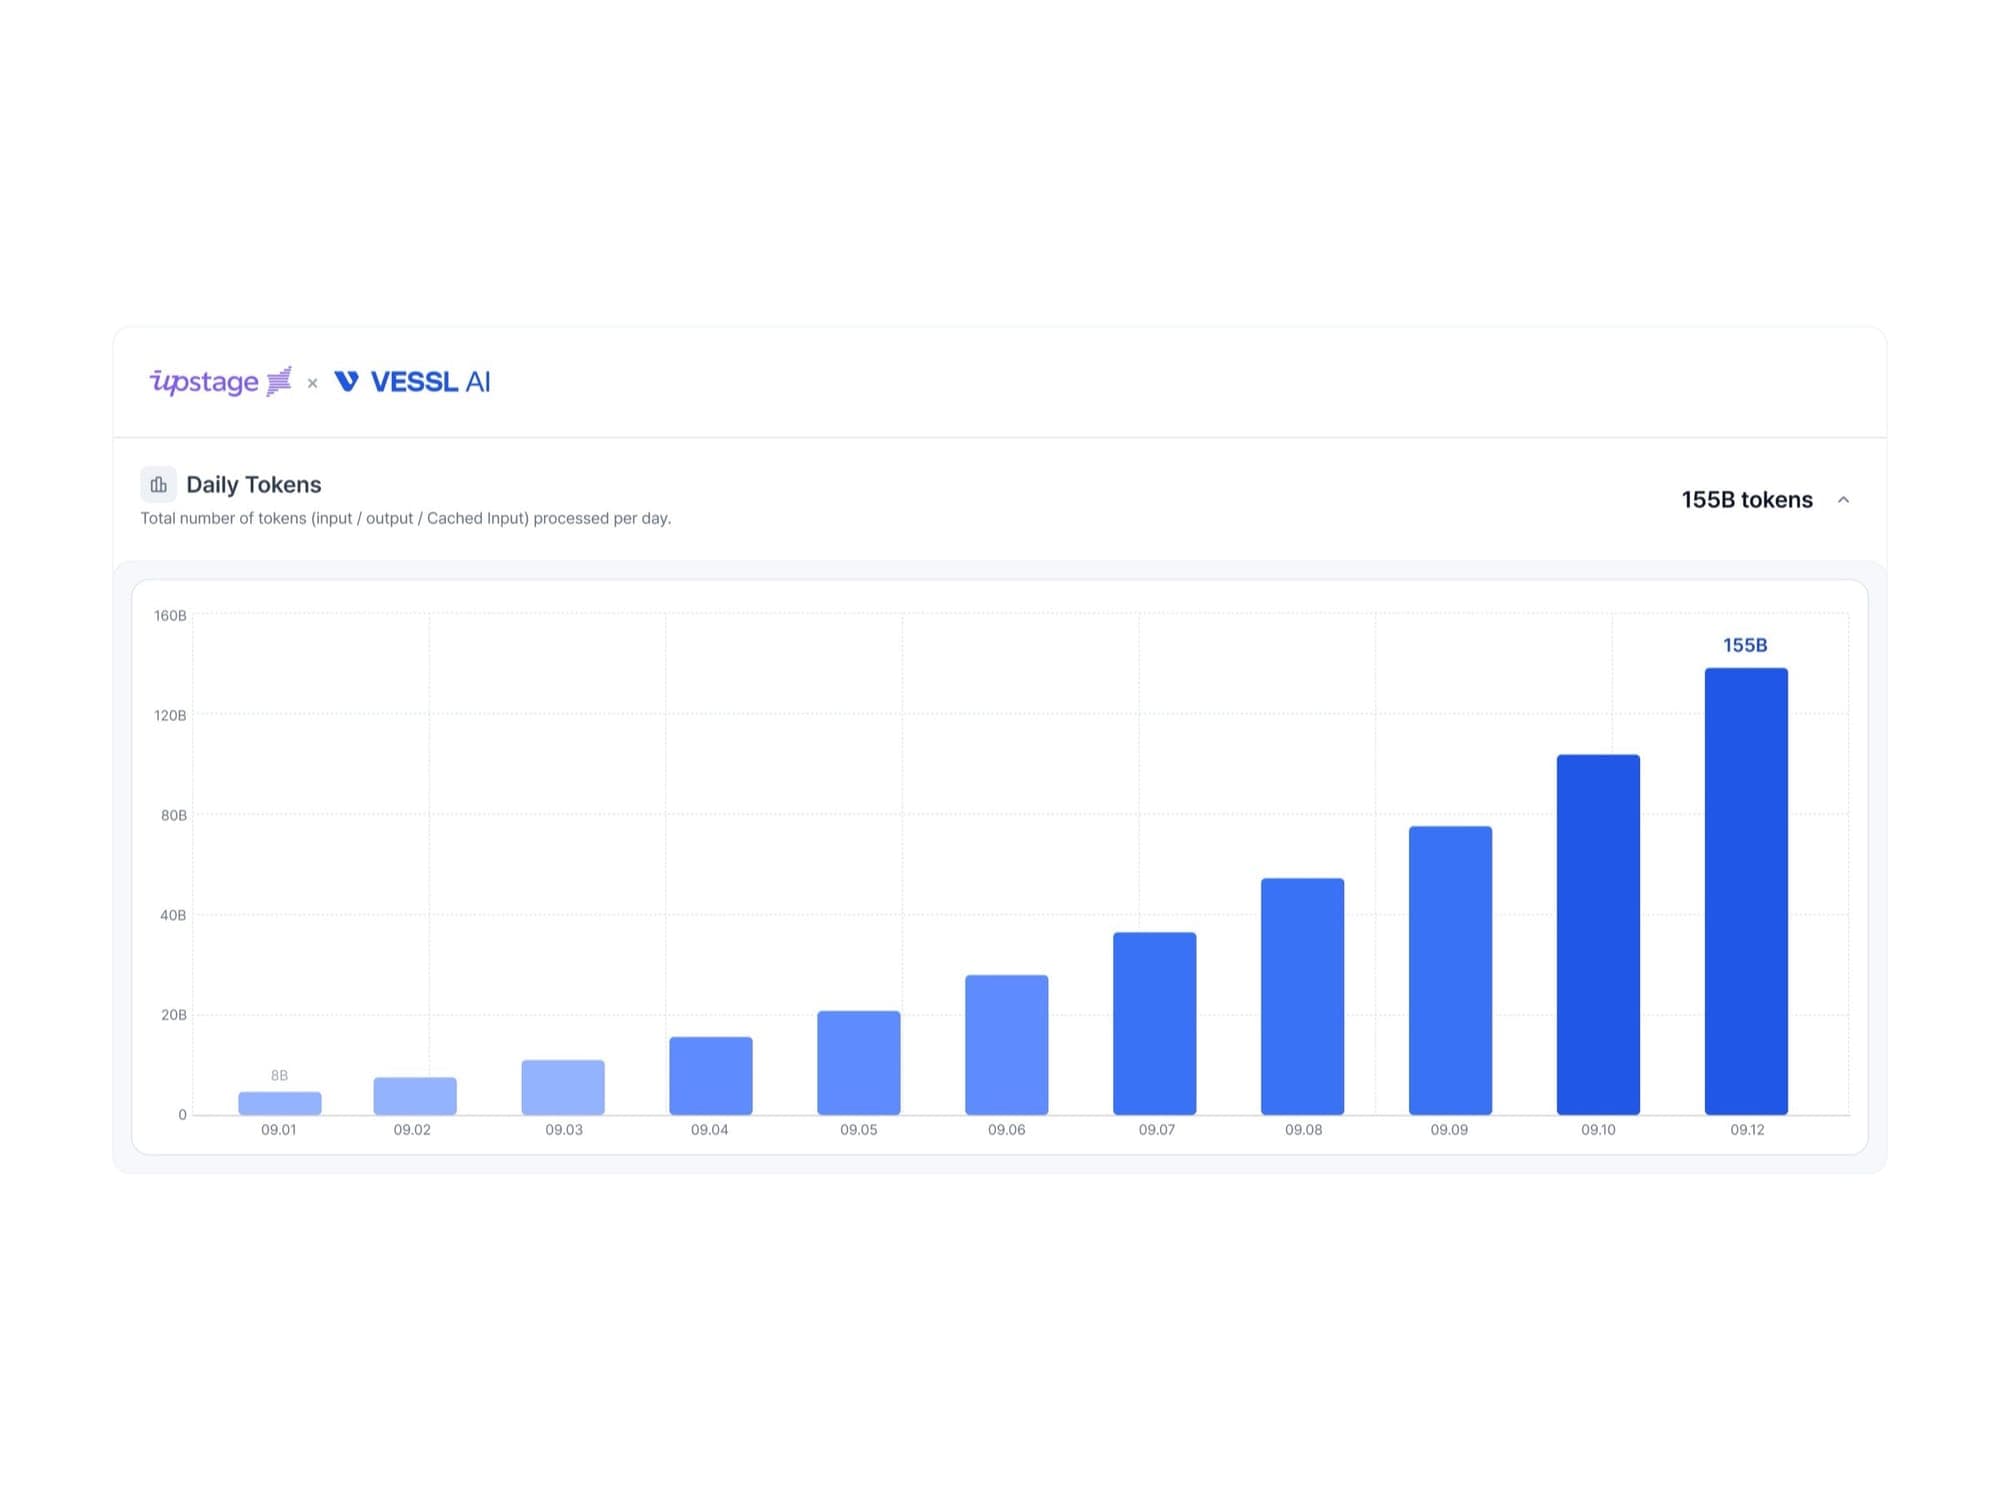
- 솔라 프로4는 글로벌 LLM 중개 플랫폼 오픈라우터에서 9월 무렵 사용량 3위에 올랐어요. 이 기간 서비스를 베슬AI 인프라가 받쳤어요.
- 캐시 활용률을 높이고 양자화 기법을 적용해 처리 속도를 평균 2배, 최대 3배 높였고, 토큰당 비용은 최대 절반으로 낮췄어요.
이 글은 베슬AI, 업스테이지 '솔라 프로4' 글로벌 추론 운영 맡아 기사를 바탕으로 VESSL AI에서 정리했어요.
모델을 잘 만드는 것과 그 모델을 전 세계 이용자에게 끊김 없이 내놓는 건 전혀 다른 일이에요. 학습은 정해진 기간 안에 끝나는 프로젝트지만, 서비스는 출시 다음 날부터 매일 돌아가야 하는 운영이거든요. 요청이 언제 얼마나 몰릴지 모르고, 응답이 느려지면 이용자는 바로 다른 모델로 떠나요.
업스테이지는 이 운영을 베슬AI에 맡겼어요. 베슬AI는 업스테이지의 새 모델 솔라 프로4가 글로벌 시장에서 사용량을 빠르게 늘리던 기간, 한국과 유럽, 미국의 데이터센터에 있는 GPU 서버로 전 세계에서 들어오는 요청을 처리했어요.
베슬AI는 솔라 프로4 서비스에서 어떤 역할을 맡았나요?
솔라 프로4의 글로벌 추론 운영이에요. 이용자가 솔라 프로4에 질문을 보내면, 그 요청을 받아 GPU에서 모델을 돌리고 답을 돌려주는 과정 전체를 베슬AI 인프라가 처리했어요.
솔라 프로4는 여러 AI 모델을 한곳에서 골라 쓰는 글로벌 LLM 중개 플랫폼 오픈라우터(OpenRouter)에서 9월 무렵 사용량 3위에 올랐어요. 전 세계 개발자가 수많은 모델을 나란히 놓고 고르는 곳에서 한국 모델이 상위권에 오른 셈이고, 그 트래픽을 받아낸 곳이 베슬AI예요.
AI 모델 추론(인퍼런스) 운영이란 무엇인가요?
학습을 마친 AI 모델을 실제 서비스에서 돌려 이용자 질문에 답을 내놓는 과정을 추론, 영어로 인퍼런스(inference)라고 해요. 추론 운영은 이 과정을 안정적으로, 빠르게, 감당할 수 있는 비용으로 유지하는 일이에요.
학습이 GPU를 한동안 크게 쓰는 일이라면, 추론은 GPU를 매일 쉬지 않고 쓰는 일이에요. 요청 한 건 한 건은 작아도 이용자가 늘수록 처리량이 그대로 쌓이고, 응답 속도와 토큰당 비용이 곧 서비스 경쟁력이 돼요.
출시·프로모션 기간에 몰리는 요청은 어떻게 대비했나요?
업스테이지와 일정과 예상 수요를 미리 공유해 필요한 처리 용량을 함께 설계했어요. 새 모델 출시나 프로모션 기간에는 이용 요청이 짧은 시간에 몰리기 때문에, 그때 가서 GPU를 찾으면 늦어요.
베슬AI는 출시·프로모션 일정을 바탕으로 필요한 용량을 먼저 잡고, 솔라 프로4의 모델 특성과 실제 이용 패턴에 맞춰 GPU 자원과 서비스 인프라를 구성했어요. 데이터센터 한 곳이 아니라 한국·유럽·미국에 걸친 GPU를 묶어 쓴 것도 전 세계에서 들어오는 요청을 받기 위해서예요.
솔라 프로4의 추론 속도와 토큰당 비용은 얼마나 개선됐나요?
처리 속도는 평균 2배, 최대 3배까지 빨라졌고, 처리하는 단어 단위인 토큰(token)당 비용은 최대 절반으로 낮아졌어요. 같은 GPU로 더 많은 요청을 더 싸게 처리하게 된 거예요.
여기에 쓰인 기술은 두 가지예요. 하나는 캐시(cache) 활용률을 높인 거예요. 같은 계산 결과를 다시 쓰면 GPU가 똑같은 연산을 반복하지 않아도 돼요. 다른 하나는 양자화(quantization)예요. 모델이 쓰는 숫자의 정밀도를 낮춰 모델을 가볍게 만들면, 메모리를 덜 쓰고 연산도 빨라져요.
안재만 베슬AI 대표는 "한국에서 개발한 모델의 글로벌 성과를 한국 네오클라우드의 인프라로 뒷받침했다는 데 의미가 있다"며 "모델 개발사가 연구와 제품 개발에 집중할 수 있도록 추론 운영 역량을 강화하겠다"고 말했어요.
베슬AI는 왜 GPU 공급에서 추론 운영으로 사업을 넓히나요?
모델 개발사에게 필요한 게 GPU만이 아니기 때문이에요. GPU를 빌려도 용량 설계, 트래픽 대응, 속도·비용 최적화는 여전히 누군가 해야 하는 일이고, 이 부담을 덜어야 개발사가 연구와 제품에 집중할 수 있어요.
베슬AI는 최근 SK바이오팜에 AI 연구개발용 GPU 인프라를 공급했고, 네오AI와 포항 AI 데이터센터의 GPU 플랫폼 구축·운영 협약을 맺었어요. 이번 솔라 프로4 추론 운영으로 GPU 인프라 공급에서 AI 모델 서비스 운영까지 사업 영역을 넓히고 있어요.
VESSL Cloud는 Workspace, 배치 Job, VM Cluster 세 가지 방식으로 GPU를 빌려 쓰는 베슬AI의 GPU 클라우드예요.
오픈 모델을 서비스로 운영해야 하는 팀을 위해서는 처리량을 계약 단위로 보장하는 Provisioned Throughput도 제공해요.
우리 팀 모델의 추론 운영도 맡길 수 있을까요?
네, 가능해요. 모델 출시 일정, 예상 트래픽, 목표 응답 속도만 알려주시면 필요한 처리 용량과 GPU 구성을 함께 설계해드릴게요. 정확한 수치가 아직 없어도 괜찮아요.
자주 묻는 질문
베슬AI는 업스테이지 솔라 프로4에서 어떤 일을 맡았나요?
솔라 프로4의 글로벌 추론(인퍼런스) 운영을 맡았어요. 한국·유럽·미국 데이터센터의 GPU 서버로 전 세계 이용자가 솔라 프로4에 보내는 요청을 처리했어요. 솔라 프로4는 이 기간 글로벌 LLM 중개 플랫폼 오픈라우터에서 9월 무렵 사용량 3위에 올랐어요.
AI 모델 추론(인퍼런스)이란 무엇인가요?
학습을 마친 AI 모델을 실제 서비스에서 돌려 이용자 질문에 답을 내놓는 과정이에요. 학습은 정해진 기간 동안 GPU를 크게 쓰는 일이고, 추론은 서비스가 돌아가는 내내 GPU를 쓰는 일이에요. 그래서 응답 속도와 토큰당 비용이 서비스 경쟁력으로 직결돼요.
베슬AI는 솔라 프로4의 추론 속도와 비용을 어떻게 개선했나요?
같은 계산 결과를 다시 쓰는 캐시의 활용률을 높이고, 모델을 가볍게 만드는 양자화 기법 등을 적용했어요. 그 결과 처리 속도를 평균 2배, 최대 3배까지 높이고 토큰당 비용을 최대 절반으로 낮췄어요.
자체 개발한 AI 모델의 추론 운영을 베슬AI에 맡기려면 어떻게 시작하나요?
모델 출시 일정, 예상 트래픽, 목표 응답 속도 세 가지를 정리해 상담을 신청하시면 돼요. 베슬AI가 필요한 처리 용량과 GPU 구성을 함께 설계해드려요. 정확한 수치가 아직 없어도 상담할 수 있어요.
이어 읽기
VESSL AI
뉴스레터 구독
AI 인프라 구축 노하우와 최신 GPU 소식을 매달 보내드려요.