기술 사양
H100 NVIDIA H100 SXM | H200 NVIDIA H200 SXM | |
|---|---|---|
| 아키텍처 | Hopper | Hopper |
| GPU 메모리 | 80GB HBM3 | 141GB HBM3e |
| 메모리 대역폭 | 3.35 TB/s | 4.8 TB/s |
| NVLink | 900 GB/s | 900 GB/s |
| FP16/BF16 (텐서) | 1,979 TFLOPS | 1,979 TFLOPS |
| FP8 (텐서) | 3,958 TFLOPS | 3,958 TFLOPS |
| 최대 TDP | 700W | 700W |
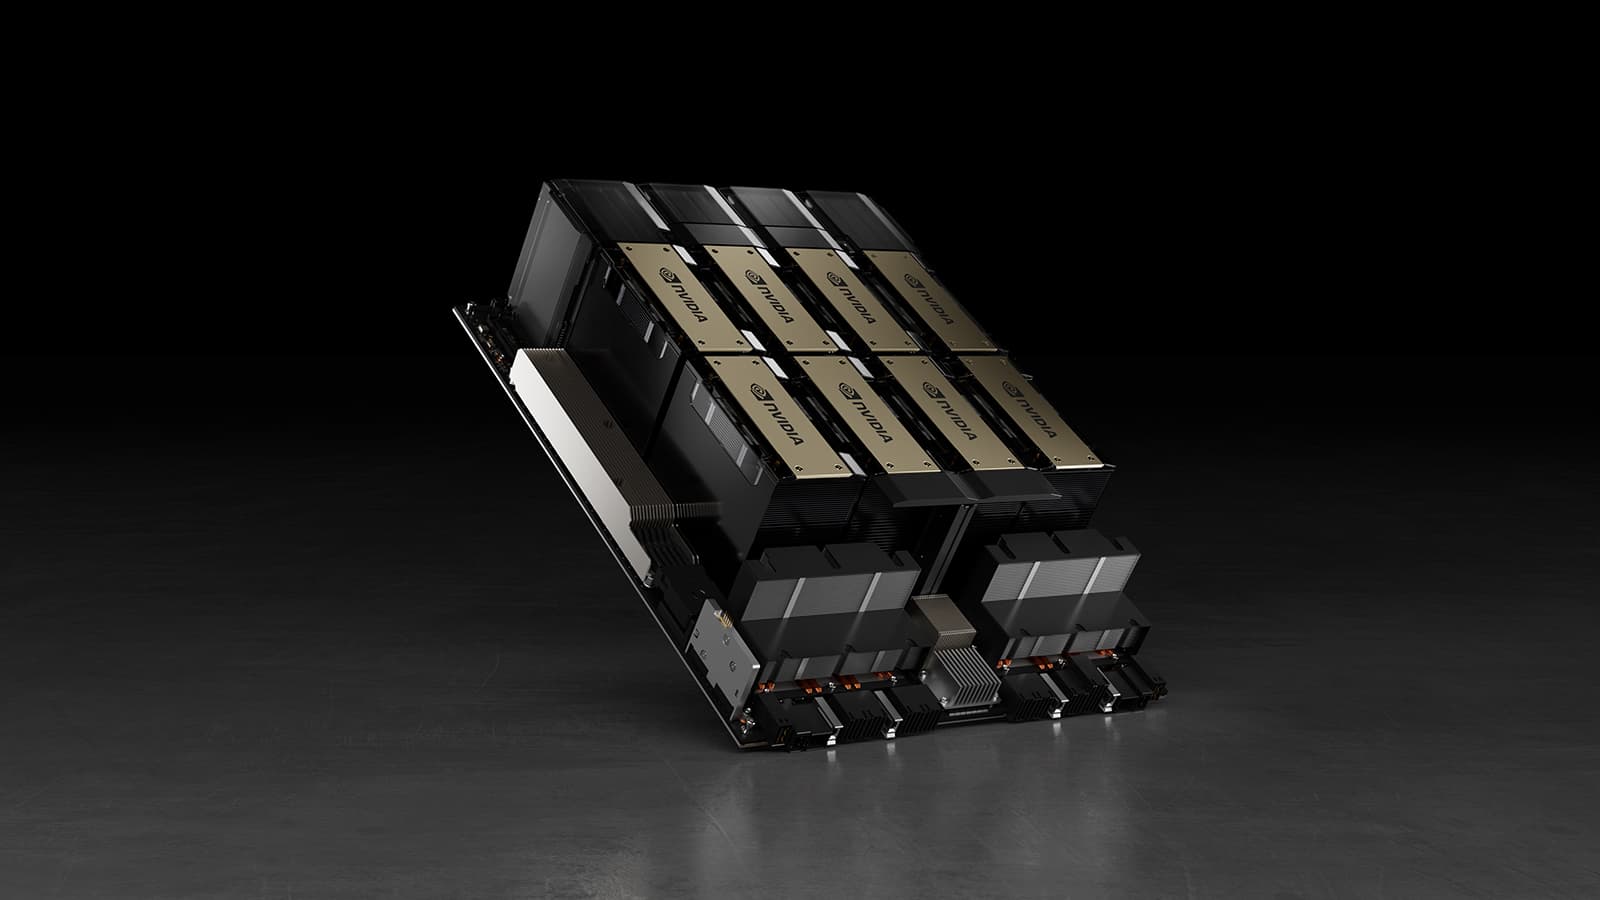
| 노드당 GPU | 8 (HGX H100) | 8 (HGX H200) |
*희소성(sparsity) 적용 시 이론상 최대 성능이며 NVIDIA 공식 사양 기준이에요. 노드 구성에 따라 달라질 수 있어요.
Hopper는 어디에 쓰면 좋을까요?
대규모 LLM 학습과 파인튜닝
검증된 Hopper 스택과 FP8 텐서 코어, 고속 InfiniBand로 70B~400B급 모델까지 멀티 노드로 학습할 수 있어요.
높은 처리량 LLM 추론
H200의 141GB HBM3e면 70B급 모델도 단일 GPU에 올라가고, H100 FP8 가속으로 토큰 처리량은 높이고 응답 지연은 낮춰요.
연구와 HPC
성숙한 CUDA, PyTorch, JAX, NeMo 생태계 위에서, 실험, 과학 계산, 일정이 촉박한 연구 워크로드를 필요할 때 바로 실행할 수 있어요.
앞서가는 팀들이 VESSL Cloud를 선택한 이유
여러 클라우드를 한곳에서
여러 클라우드의 GPU를 한곳에 모아둬서, 클라우드마다 할당량을 신청하고 따로 계약할 필요가 없어요.
한 노드부터 클러스터까지
한 노드에서 GPU를 최대 8장까지 쓰고, 한 노드로 부족하면 InfiniBand로 묶은 멀티노드 VM Cluster로 넘어가요.
투명한 요금
셀프서브 GPU는 초 단위 요금을 공개하고, 예약형은 GPU와 기간, 물량에 맞춰 견적을 드려요.
엔터프라이즈 보안도 문제없어요
SOC 2 Type II 인증에 상용 AI 전담 지원까지 갖춰서, 엔터프라이즈 규모에서도 안심하고 쓸 수 있어요.
자주 묻는 질문
VESSL Cloud에서 NVIDIA H100 가격은 얼마인가요?
H100 SXM(80GB)은 온디맨드 시간당 $2.98부터예요. 예약형 요금은 기간과 물량에 따라 정해요. cloud.vessl.ai에서 바로 시작할 수 있어요.
H100과 H200은 뭐가 다른가요?
둘 다 Hopper 연산 성능은 같지만, H200은 더 빠른 HBM3e 메모리를 141GB(H100은 80GB HBM3) 탑재하고 대역폭이 4.8 TB/s예요. 더 큰 모델, 더 큰 배치(batch), 더 긴 문맥(context)에 유리해요.
H200도 지금 쓸 수 있나요?
H200은 전용 VM Cluster 예약형으로 제공해요. 현재 가용 물량과 가격은 팀에 문의해 주세요.
H100과 H200 멀티 노드 학습이 가능한가요?
가능해요. VM Cluster에서 8장 단위 HGX H100 또는 H200 노드를 고속 InfiniBand로 묶어 분산 학습을 할 수 있어요.
예약형 할인이 있나요?
예약형은 계약 기간 동안 물량을 확보해 드려요. 요금 조건은 팀에 문의해 주세요.