Speculative Decoding Part 2: 드래프터 아키텍처는 어떻게 발전했나
2부작 중 2편입니다. 1편에서는 기본적인 방정식과 네 가지 레버(lever, 속도 향상을 끌어올리는 방법)를 다뤘습니다.
TL;DR
- 드래프터(drafter) 설계는 드래프트(draft)의 조건화(conditioning, 예측의 근거가 되는 정보) 신호를 어디서 가져올지를 중심으로 발전해 왔습니다.
- 처음에는 토큰을 병렬로 제안했고, 이후 점점 자기회귀(autoregressive) 방식으로 바뀌었다가, 최근 설계는 가벼운 순차 보정을 더해 다시 병렬 방식으로 돌아왔습니다.
- 그 과정에서 두 가지 답이 하나씩 드러났습니다. 하나는 조건화를 토큰이 아니라 피처(feature)에서 가져와야 한다는 점이고, 다른 하나는 각 위치(position)에 앞 위치에서 실제로 샘플링된 토큰을 제공하면 그 소모 비용보다 수락률(acceptance rate) 향상 효과가 더 크다는 점입니다.
들어가며
1편 에서는 아래 식을 다뤘습니다.
드래프터는 정확하면서도 저렴해야 하는데, 이 두 조건은 서로 맞바꿔야 하는(trade-off) 관계입니다.
아키텍처 연구는 결국 "드래프트의 조건화 신호는 어디서 오는가"라는 질문 하나에 답해 왔습니다. 여기서 조건화란 드래프터가 위치 를 예측할 때 무엇을 근거로 삼는지를 뜻합니다. 트렁크(trunk)의 은닉 상태(hidden state) 하나만 볼 수도 있고, 앞 토큰을 실제로 넣어 드래프터를 순차적으로 다시 실행할 수도 있습니다.
모든 드래프터는 두 가지를 정합니다. 무엇을 보느냐가 를 정하고, 순차 단계를 몇 번 거치느냐가 를 정합니다. 문제는 가장 저렴한 조건화가 정보량도 가장 적다는 점입니다.
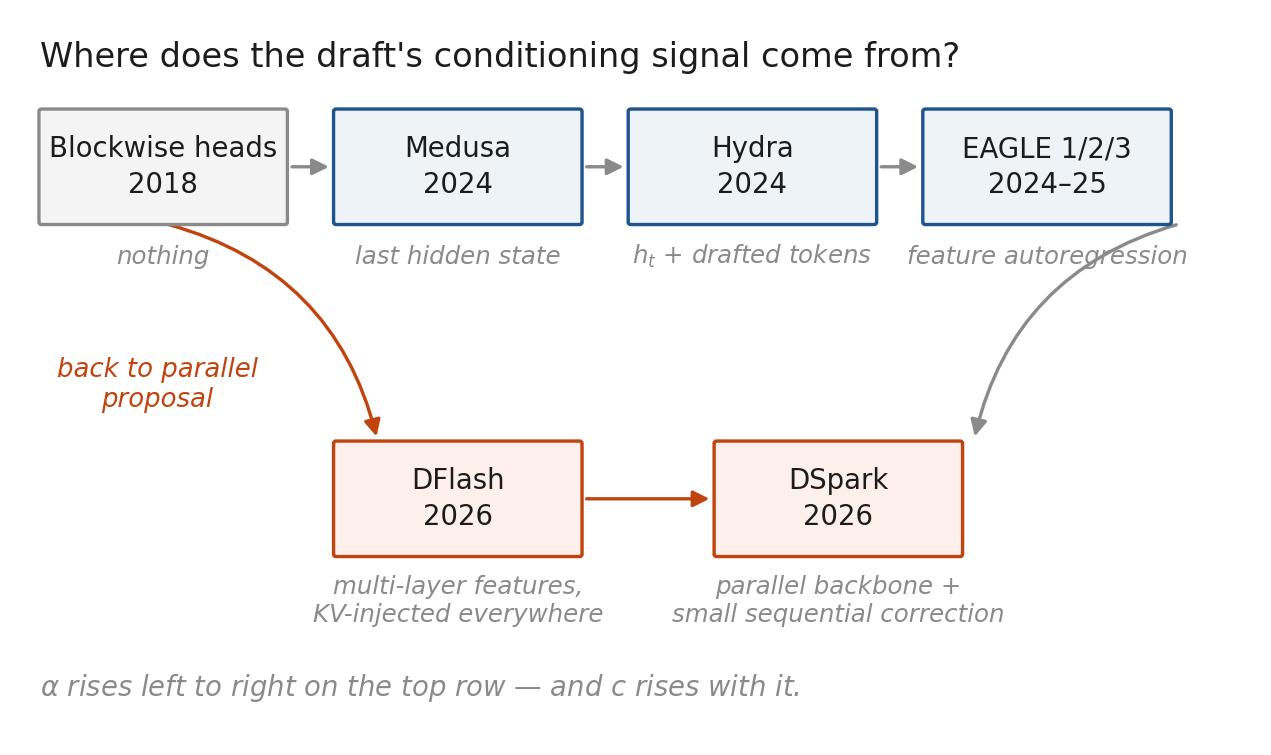
초기 드래프터는 토큰을 병렬로 제안했습니다. 이후에는 자기회귀 성격이 점점 강한 설계로 이어졌고, 가장 최근 설계들은 가벼운 순차 보정을 더해 다시 병렬 방식으로 돌아왔습니다.
조건화가 없던 Blockwise decoding
Blockwise parallel decoding은 출력 헤드(output head)를 개 붙이고, 헤드 가 공유된 트렁크 상태(trunk state) 로부터 를 예측합니다:
한 번의 순전파(forward pass)로 검증하고, 앞에서부터 가장 길게 일치하는 접두부(prefix)를 받아들입니다. 이는 오늘날 투기적 디코딩(speculative decoding)의 기본 구조라고 볼 수 있습니다. 다만 헤드끼리 서로의 출력을 조건으로 삼을 방법이 없습니다. 이 구조에서 헤드 2는 헤드 1이 무엇을 만들었는지 모릅니다.
이 구조를 그대로 가져가 헤드 쪽을 다듬은 것이 Medusa입니다.
백본에 헤드를 붙인 Medusa
Medusa는 백본(backbone)의 마지막 은닉 상태에 독립적인 헤드를 개 붙입니다. 각 헤드는 잔차(residual) FFN 블록 하나입니다:
을 0, 를 LM 헤드 사본으로 초기화하면 각 헤드는 백본 자신의 다음 토큰 예측에서 출발합니다. 그래서 새로운 예측기(predictor)를 학습하는 것이 아니라, 그 예측을 칸 앞으로 옮기는 부분만 학습합니다.
손실(loss)은 위치가 뒤로 갈수록 가중치를 줄이는 교차 엔트로피(cross-entropy)입니다. 헤드 가 앞 위치가 모두 통과했을 때만 쓰이기 때문입니다. 헤드 1이 틀리면 드래프트가 거기서 끊기고 뒤쪽 헤드의 출력은 쓸모가 없어지므로, 같은 학습 예산이라면 앞쪽 헤드에 쓰는 편이 낫습니다.
가중치를 줄이는 비율이 얼마여야 하는지는 계산으로 구할 수 있고, 대략 에 비례합니다. 그런데 실제로 쓰이는 값은 이렇게 계산한 값이 아닙니다. Medusa는 를 쓰면서 논문에 "0.8 같은 상수"라고만 적었고, EAGLE-3의 공개 코드도 같은 0.8을 씁니다. DFlash는 블록 크기(block size)에 맞춰 7, 5, 4를 골라 씁니다. DSpark는 감쇠율을 블록 크기에 묶어두어 따로 고르지 않습니다. 어느 쪽도 를 보고 정하지는 않는데, 고정된 값을 쓰면 가 고정이라고 가정하는 셈이 됩니다. 는 도메인마다 다르고 같은 문장 안에서도 위치마다 달라지므로, 학습 시점에 지정해둔 감쇠율이 서빙(serving) 시점에서는 잘 맞지 않을 수 있습니다.
헤드 사이를 이은 Hydra
Medusa의 헤드들은 가 주어졌을 때 서로 조건부 독립입니다. Hydra는 앞서 생성한 드래프트 토큰의 임베딩을 뒤쪽 헤드의 입력으로 넣습니다:
다만 이 글에서 Hydra가 중요한 이유는 아키텍처가 아니라 측정에 있습니다. 저자들이 같은 베이스 모델(base model)에 EAGLE 헤드를 학습시켜 비교했더니, EAGLE의 평균 수락 길이(accepted length)가 더 높은데도 두 방법의 처리량(throughput)은 비슷하게 나왔습니다.
Hydra 논문은 이를 EAGLE 드래프트 헤드의 비용 때문이라고 설명합니다. EAGLE은 후보 후속 시퀀스(continuation)의 모든 위치마다 전체 셀프 어텐션 블록(full self-attention block)을 한 번씩 실행합니다. Hydra는 디코딩 단계(decoding step)당 한 번만 실행합니다. EAGLE은 를 얻고 Hydra는 를 아끼는데, 결과적으로 는 비슷해집니다.
피처 레벨로 내려간 EAGLE
EAGLE의 기여는 드래프터가 무엇을 예측해야 하는지를 다시 정의한 데 있습니다.
작은 드래프터에게는 토큰 단위 자기회귀가 잘못된 층위입니다. 토큰 열은 엔트로피가 높습니다. 반면 피처 열, 즉 타깃(target)이 LM 헤드에 넣기 직전의 은닉 상태(끝에서 두 번째 레이어) 열은 매끄러워서 디코더 레이어(decoder layer) 하나로 외삽이 가능합니다. 남는 정보는 "실제로 어떤 토큰이 샘플링되었는가" 하나뿐이고, 이 정보는 별도로 입력합니다:
인덱스가 한 칸 어긋나 있다는 점에 주목해야 합니다. 의 피처가 의 임베딩과 짝을 이룹니다. 샘플링이 개입했기 때문에 만으로는 이 정해지지 않습니다. 그래서 드래프터의 역할은 예측이 아니라 실현된 샘플을 조건으로 한 외삽이 되고, 이쪽이 훨씬 쉬운 문제입니다.
손실 함수는 다음과 같습니다:
피처 회귀가 주 항목이고 토큰 예측이 0.1 가중치를 받습니다. 어느 쪽이 주 항목인지 기억해 둘 필요가 있습니다. EAGLE-3가 이 주 항목을 통째로 버리고, 0.1을 받던 쪽만 남기기 때문입니다.
EAGLE-2는 드래프트 트리의 모양을 고정해두지 않습니다. 각 가지의 점수는 루트부터 그 가지까지의 신뢰도(confidence)를 곱한 값으로 매기는데, 이 값은 그 가지가 실제로 쓰일 확률의 추정치입니다. 점수는 경로를 따라 곱해지므로 부모 노드의 점수가 자식 노드의 점수보다 항상 크거나 같고, 그래서 점수가 높은 몇 개만 골라도 그 부모 노드가 함께 포함됩니다.
EAGLE-3는 타깃의 맨 위 레이어 하나만 보던 방식에서 아래쪽, 중간, 위쪽 레이어를 섞어 보는 방식으로 바꾸고, 학습 중에 드래프터가 자기 출력을 다시 입력으로 받게 합니다. 자기 출력으로 학습하면 예측한 피처가 실제 피처와 똑같지 않아도 되므로 피처를 맞추라는 손실 항이 빠지는데, 맨 위 레이어를 쓰도록 묶어두던 요인이 바로 이 손실 항이었습니다.
EAGLE-1과 2에서는 학습과 추론이 어긋나 있었습니다. 학습할 때는 타깃이 만든 실제 피처를 받지만 추론할 때는 자기가 만든 피처로 이어가야 하므로, 드래프트가 길어질수록 예측이 점점 어긋납니다. EAGLE-3는 학습 때부터 드래프터에게 자기 출력을 입력으로 주는 방식(training-time test)으로 이 간극을 없앴고, 그래서 같은 크기의 드래프터로도 더 긴 드래프트가 수락됩니다.
사전 학습으로 간 MTP
다중 토큰 예측(multi-token prediction)은 원래 추론을 가속하려고 만든 기법이 아닙니다. 모델을 학습시킬 때 "다음 토큰 하나"가 아니라 "앞으로 올 개"를 한꺼번에 맞히게 하는 목적함수이고, 목표도 속도가 아니라 품질이었습니다. 특히 코드에서 효과가 컸습니다.
드래프터로 쓸 수 있다는 점은 그 결과로 따라왔습니다. DeepSeek-V3는 헤드를 여러 개 나란히 두는 대신 모듈을 한 줄로 이어 붙였습니다. 뒤 모듈이 앞 모듈의 결과와 그 위치에서 실제로 샘플링된 토큰을 함께 받는 구조인데, 표현에 토큰 임베딩을 이어 붙이는 방식은 EAGLE과 똑같습니다. 서로 다른 동기에서 같은 설계에 도달한 셈입니다.
공개된 설정은 모듈이 레이어 하나뿐이고(), 서빙 시에는 이 모듈을 토큰 하나를 미리 생성하는 드래프터로 씁니다. 두 번째 토큰이 85~90% 확률로 통과하고 TPS는 약 1.8배입니다. 1편의 식에 대입하면 드래프터 비용 가 약 0.04로 나오는데, 61개 레이어 중 하나라면 0.016이어야 하므로 약 2.5배입니다. 모듈이 레이어 하나만 실행하는 것이 아니라, 결과를 토큰 확률로 바꾸기 위해 어휘 전체에 대한 투영까지 계산하기 때문입니다.
하지만 가 사전 학습(pretraining) 때 다른 목적에 맞춰 이미 정해져 있으므로, 서빙하는 쪽에서는 모델을 다시 학습시키지 않는 한 바꿀 수 없습니다.
블록을 한 번에 채우는 DFlash
DFlash는 토큰을 하나씩 생성하는 대신 빈칸을 나란히 놓고 한 번에 채웁니다. 앞을 가리던 마스크를 풀어 모든 위치가 서로를 참조하게 하므로, 드래프트에 필요한 순전파가 번이 아니라 한 번으로 줄어듭니다.
이것이 가능한 이유는 KV 주입(KV injection)입니다. 타깃의 여러 레이어에서 가져온 은닉 상태를 드래프트 쪽 공간으로 투영한 다음, 드래프트의 모든 레이어가 참조하는 키(key)와 값(value)에 추가합니다. 덕분에 드래프터는 계산하는 내내 타깃의 상태를 함께 참조합니다.
추가로 학습해야 하는 파라미터는 이 투영 행렬 하나뿐입니다. bf16 기준 약 42 MB로, 70 GB 규모인 타깃 모델에 비하면 메모리 부담은 사실상 없습니다.
주입을 첫 레이어에서 한 번만 하지 않는 데도 이유가 있습니다. 입력 단계에서만 넣으면 타깃의 정보가 드래프트 자체의 계산과 섞여 레이어를 지날수록 희석되므로, 드래프트를 깊게 쌓아도 수락(acceptance)은 오르지 않고 만 커집니다. 모든 레이어의 키와 값에 계속 주입하면 깊은 레이어도 타깃의 정보를 직접 받게 되고, 그때부터 깊이를 늘린 만큼 수락도 함께 올라갑니다. DFlash가 드래프트를 다섯 레이어까지 키운 근거가 이것입니다.
결합 분포를 되돌린 DSpark
DSpark는 병렬 백본에 두 가지를 더합니다.
첫째는 가벼운 순차 단계입니다. 백본이 출력한 각 위치의 점수에 직전 토큰에 따라 달라지는 값을 더해, 블록 안의 위치들이 서로 이어지게 만듭니다. 이 값을 어휘 전체 크기의 표로 저장하는 대신 랭크(rank) 256으로 압축해서, 단계당 비용이 에 그칩니다.
둘째는 검증(verification) 길이를 정하는 일이 스케줄링 문제가 된다는 점입니다. 신뢰도 헤드(confidence head)가 위치마다 "앞 위치가 모두 통과했다는 조건에서 이 위치도 통과할 확률"을 예측하고, 학습에 쓰는 정답은 입니다. 1편에서 정리(theorem)로 다룬 값이 여기서는 토큰마다 붙는 레이블이 됩니다.
이 예측값은 보정(calibration)을 거칩니다. 임곗값(threshold) 방식은 순위만 맞으면 되지만, 확률을 곱해 기대 길이를 계산하는 스케줄러는 값의 크기까지 정확해야 하기 때문입니다. 각 값이 조금씩 높게 나오면 곱할수록 오차가 커져서, 일 때 위치마다 10%씩 높게 나오면 최종 추정치는 실제보다 약 95% 커집니다.
그다음 스케줄러는 배치 안의 모든 요청을 대상으로 통과 확률이 높은 위치부터 검증 예산을 배분하면서, 측정해 둔 하드웨어 곡선에 맞춰 전체 처리량을 최대화합니다. 즉, 는 미리 정해둔 숫자가 아니라, 요청마다 그리고 부하에 따라 달라지는 값이 됩니다.
어블레이션(ablation) 결과 하나가 이 교환 관계를 보여줍니다. 레이어 2개인 DSpark가 레이어 5개인 DFlash를 앞섭니다. 순차 보정이 깊이를 보완하는 데 그치지 않고 깊이를 대신한다는 뜻입니다.
정리
드래프터 설계는 병렬에서 출발해 점점 자기회귀 방식으로 바뀌었다가 다시 병렬로 돌아왔습니다. 다만 돌아온 자리는 출발점과 다릅니다. 그 사이에 두 가지 답이 하나씩 드러났습니다. 하나는 조건화를 토큰이 아니라 피처에서 가져와야 한다는 점이고, 다른 하나는 각 위치에 앞 위치에서 실제로 샘플링된 토큰을 제공하면 그 소모 비용보다 수락률 향상 효과가 더 크다는 점입니다. 특히 두 번째는 Hydra가 Medusa에, DSpark가 DFlash에 같은 보정을 더하면서 두 번 확인됐습니다.
VESSL AI
뉴스레터 구독
AI 인프라 구축 노하우와 최신 GPU 소식을 매달 보내드려요.